Dharma Field Extractor supera a modelos frontier en extracción JSON local con 2.000 millones de parámetros y hasta 147 veces menos coste
Dharma Field Extractor: modelo local de 2.000 millones de parámetros para extracción JSON que supera a APIs frontier en precisión y coste.
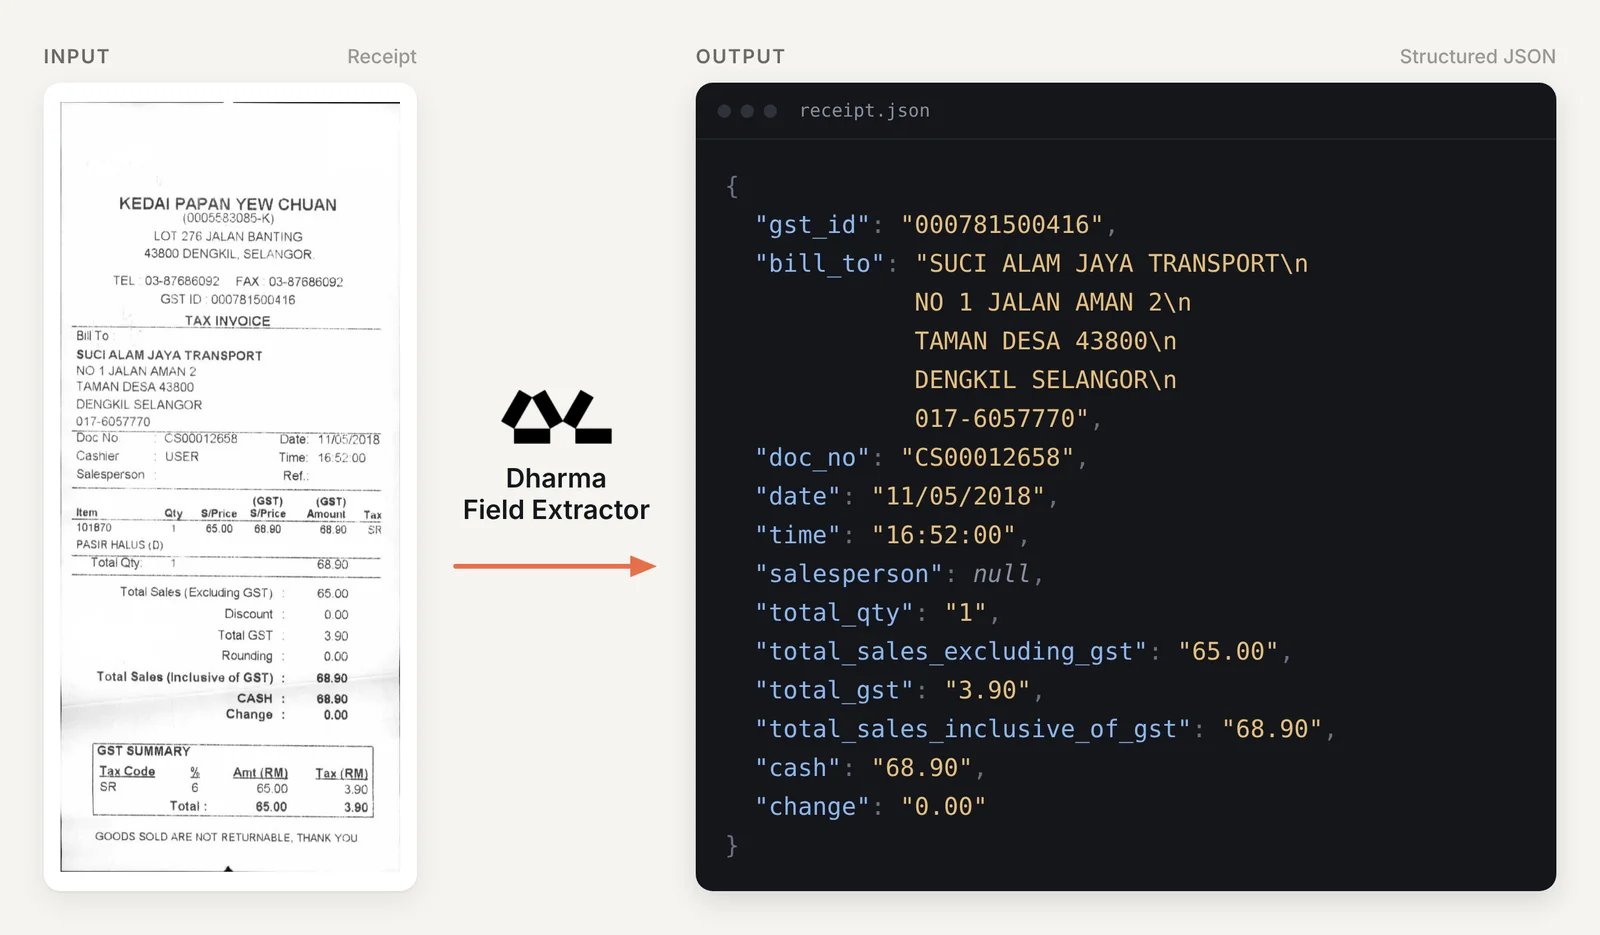
Dharma-AI ha presentado Dharma Field Extractor, un modelo especializado de 2.000 millones de parámetros que transforma imágenes de documentos en salidas JSON estructuradas y tipadas. Un único checkpoint gestiona facturas, recibos, formularios o identificaciones sin requerir fine-tuning específico por cada tipo documental.
Según exponen Gabriel Pimenta de Freitas Cardoso, Paulo Henrique de Medeiros Araujo, Bruno Duarte y Francisco de Almeida Rocha Alves en el blog de Hugging Face, el modelo resuelve las limitaciones operativas del reconocimiento óptico de caracteres (OCR) tradicional y el coste de las API comerciales. Mientras el OCR devuelve texto plano línea por línea, esta arquitectura entrega directamente campos listos para bases de datos en infraestructura propia.
Del texto plano del OCR a la extracción estructurada por esquema
En abril de 2026, la compañía publicó DharmaOCR-LITE junto al estudio académico arXiv:2604.14314, defendiendo que un modelo compacto y especializado supera a modelos generalistas frontier en tareas acotadas. El OCR resulta idóneo cuando se necesita digitalizar un documento completo de principio a fin, como un contrato o un manuscrito.
Sin embargo, numerosos flujos empresariales requieren únicamente valores concretos estructurados para sistemas posteriores: partidas individuales de una factura, datos de una solicitud médica para programar citas o campos de un documento de identidad para registros de personal. Con OCR puro, los equipos de ingeniería aún deben programar reglas de mapeo que identifiquen qué cadena corresponde a una fecha, un examen o un importe total.
Aunque un LLM generalista puede asumir esa tarea mediante prompting, hacerlo a gran volumen sobre APIs frontier dispara tanto los costes como la latencia. Dharma Field Extractor aborda este escenario aceptando la imagen del documento mediante dos modos operativos diferenciados:
- Modo abierto (open): sin esquema previo, el modelo analiza el diseño y el contexto visual —etiquetas seguidas de valores o tablas con encabezados— para devolver todos los campos detectados como pares clave-valor sin depender de una lista fija de nombres.
- Modo guiado por esquema (schema-directed): el usuario define el JSON schema exacto con el tipo de cada campo (
string,numberoboolean) y las claves de su sistema, comoservice_provideroclient_company.
En el modo guiado por esquema, las tablas se completan fila por fila y columna por columna asociando cada celda a su clave correspondiente. Si un campo solicitado no figura en la página, el modelo devuelve null en lugar de inventar datos, respetando estrictamente las claves pedidas sin añadir atributos adicionales.
Arquitectura base y entrenamiento con LoRA sobre 43.384 ejemplos
El nuevo sistema parte de DharmaOCR-LITE v1.1, una versión optimizada de 2.000 millones de parámetros derivada del modelo original de 3.000 millones de parámetros descrito en el artículo de abril. Esta base ya contaba con especialización en OCR mediante ajuste fino supervisado (SFT) y optimización directa de preferencias (DPO).
Sobre ese checkpoint, el equipo entrenó un adaptador LoRA con 43.384 ejemplos anotados a nivel de campo que cubren tanto peticiones abiertas como guiadas por esquema. La mezcla incorpora intencionadamente recibos, facturas comerciales, formularios, extractos bancarios, documentos de identidad y documentos sintéticos para evitar la especialización en un único formato.
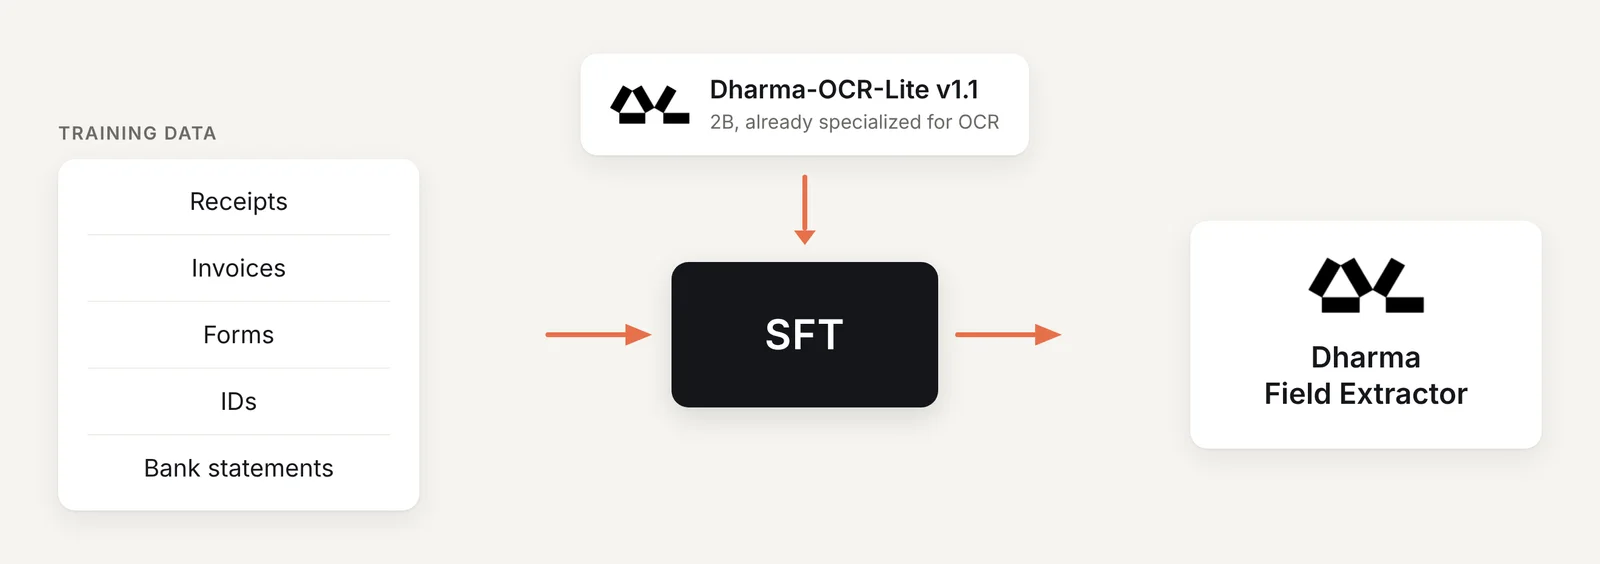
Composición de los 43.384 ejemplos anotados a nivel de campo divididos en tres flujos lingüísticos y múltiples familias documentales (Hugging Face / Dharma-AI).
El conjunto de entrenamiento se divide en tres flujos lingüísticos complementarios: datos multidominio en inglés procedentes de la web pública, documentos reales de Brasil en portugués recopilados internamente y una proporción menor de contenido multilingüe en otras lenguas europeas y asiáticas para reforzar la generalización.
Evaluación frente a modelos frontier en calidad y coste autoalojado
Para medir el rendimiento real, Dharma-AI construyó un benchmark de 546 documentos evaluados bajo tres escenarios de petición, sumando 1.638 casos en total. Las pruebas abarcaron extracción abierta sin esquema, esquemas parciales compuestos solo por campos existentes y esquemas con campos deliberadamente inexistentes para comprobar la abstención.
La métrica combinó la puntuación F1 a nivel de campo —emparejada por ruta exacta, incluida la posición dentro de tablas— multiplicada por la similitud de Levenshtein en los valores coincidentes y por la proporción de respuestas devueltas como JSON válido. Frente al modelo especializado se midieron cuatro configuraciones frontier de propósito general.
En las APIs comerciales, los modelos frontier operaron con razonamiento en nivel bajo, salvo Claude Opus 5, que empleó esfuerzo adaptativo capaz de omitir razonamiento en páginas simples dentro del mismo umbral. Los costes por API reflejan el promedio medido de tokens de entrada y salida por página, incluidos los tokens de razonamiento, frente a tarifas públicas oficiales.
Por el contrario, Dharma Field Extractor no se factura por token, sino como un modelo lingüístico pequeño especializado y soberano (SSLM) desplegado en infraestructura propia (self-hosted). El cálculo de referencia mide tiempo de GPU en una única tarjeta L40S valorada en 2,24 dólares por hora, aclarando que la cifra no constituye un precio comercial de venta y varía según hardware, volumen y latencia requerida.
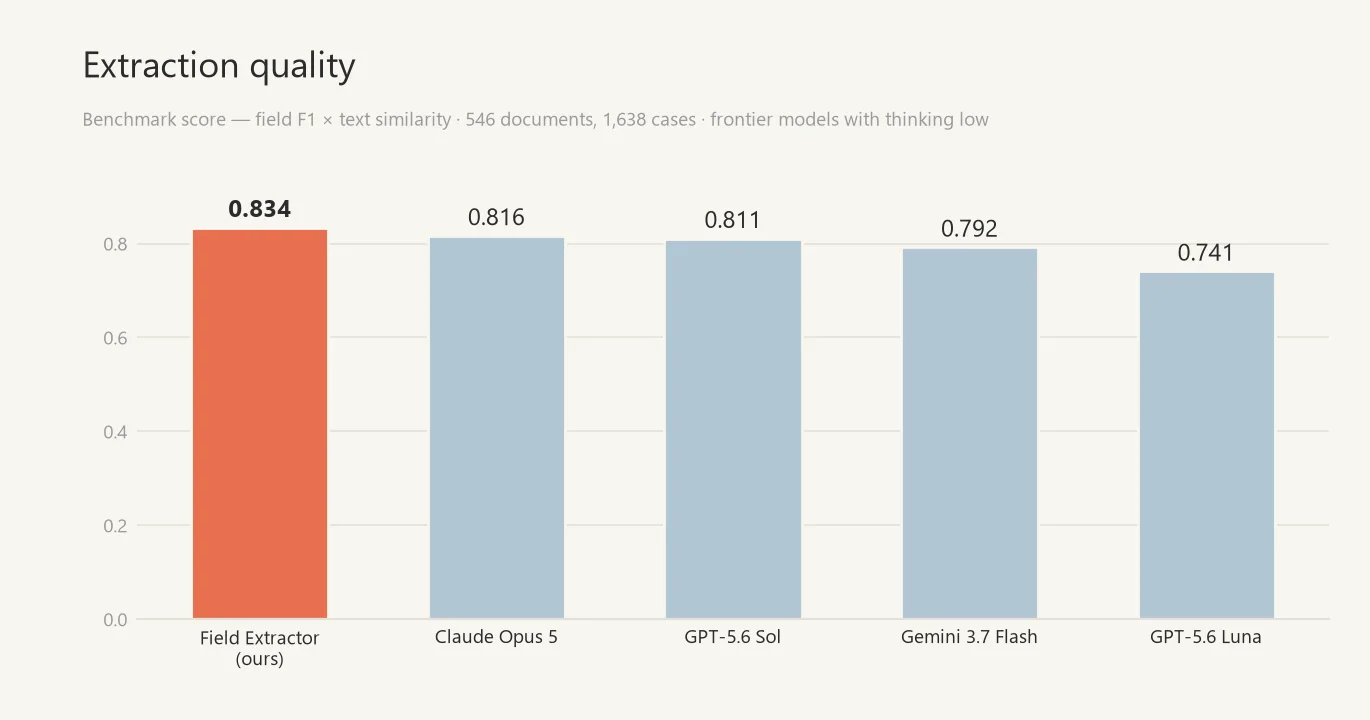
Resultados de precisión estructurada en los 1.638 casos de evaluación frente a cuatro configuraciones frontier (Hugging Face / Dharma-AI).
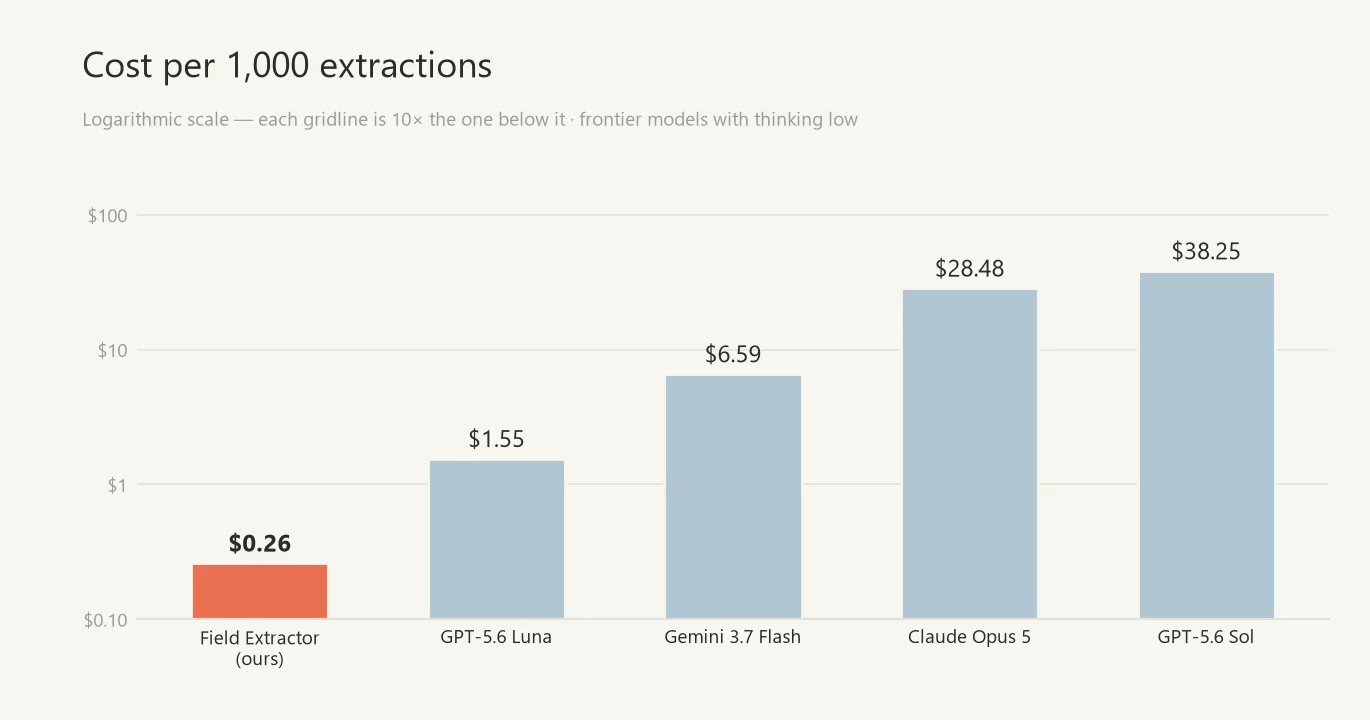
Comparativa de coste por extracción entre el despliegue autoalojado en GPU L40S y las tarifas comerciales por token (Hugging Face / Dharma-AI).
| Modelo evaluado | Entorno y configuración | Puntuación (F1 × Levenshtein × JSON válido) | Brecha frente a Dharma | Coste relativo por extracción |
|---|---|---|---|---|
| Dharma Field Extractor | Autoalojado en 1 GPU L40S (2,24 dólares/hora) | 0,834 | Referencia | 1× (menor coste medido) |
| Claude Opus 5 | API frontier (esfuerzo adaptativo bajo) | 0,816 | −1,8 puntos | Superior al autoalojamiento (ver gráfica) |
| GPT-5.6 Luna | API frontier (razonamiento bajo) | 0,741 | −9,3 puntos | ~6× mayor que Dharma |
| GPT-5.6 Sol | API frontier (razonamiento bajo) | Rango intermedio (ver gráfica) | Entre 1,8 y 9,3 puntos | ~147× mayor que Dharma |
Nota: El ensayo completo evaluó cuatro configuraciones frontier; el desglose visual completo de todas las barras figura en las gráficas comparativas superiores.
Pruebas de generalización sin entrenamiento en SROIE y FUNSD
Para verificar la capacidad de generalización fuera del dominio de entrenamiento, el benchmark reservó exclusivamente para evaluación dos conjuntos públicos clásicos: SROIE (recibos comerciales de ICDAR 2019) y FUNSD (formularios escaneados). En una muestra de SROIE, se solicitaron los 18 campos impresos en el recibo sin incluir claves inexistentes.
El modelo capturó la dirección de facturación multilínea sin etiqueta como un único campo, devolvió null en los dos campos vacíos (salesperson y ref) y reprodujo cada cifra económica exacta hasta el último céntimo.
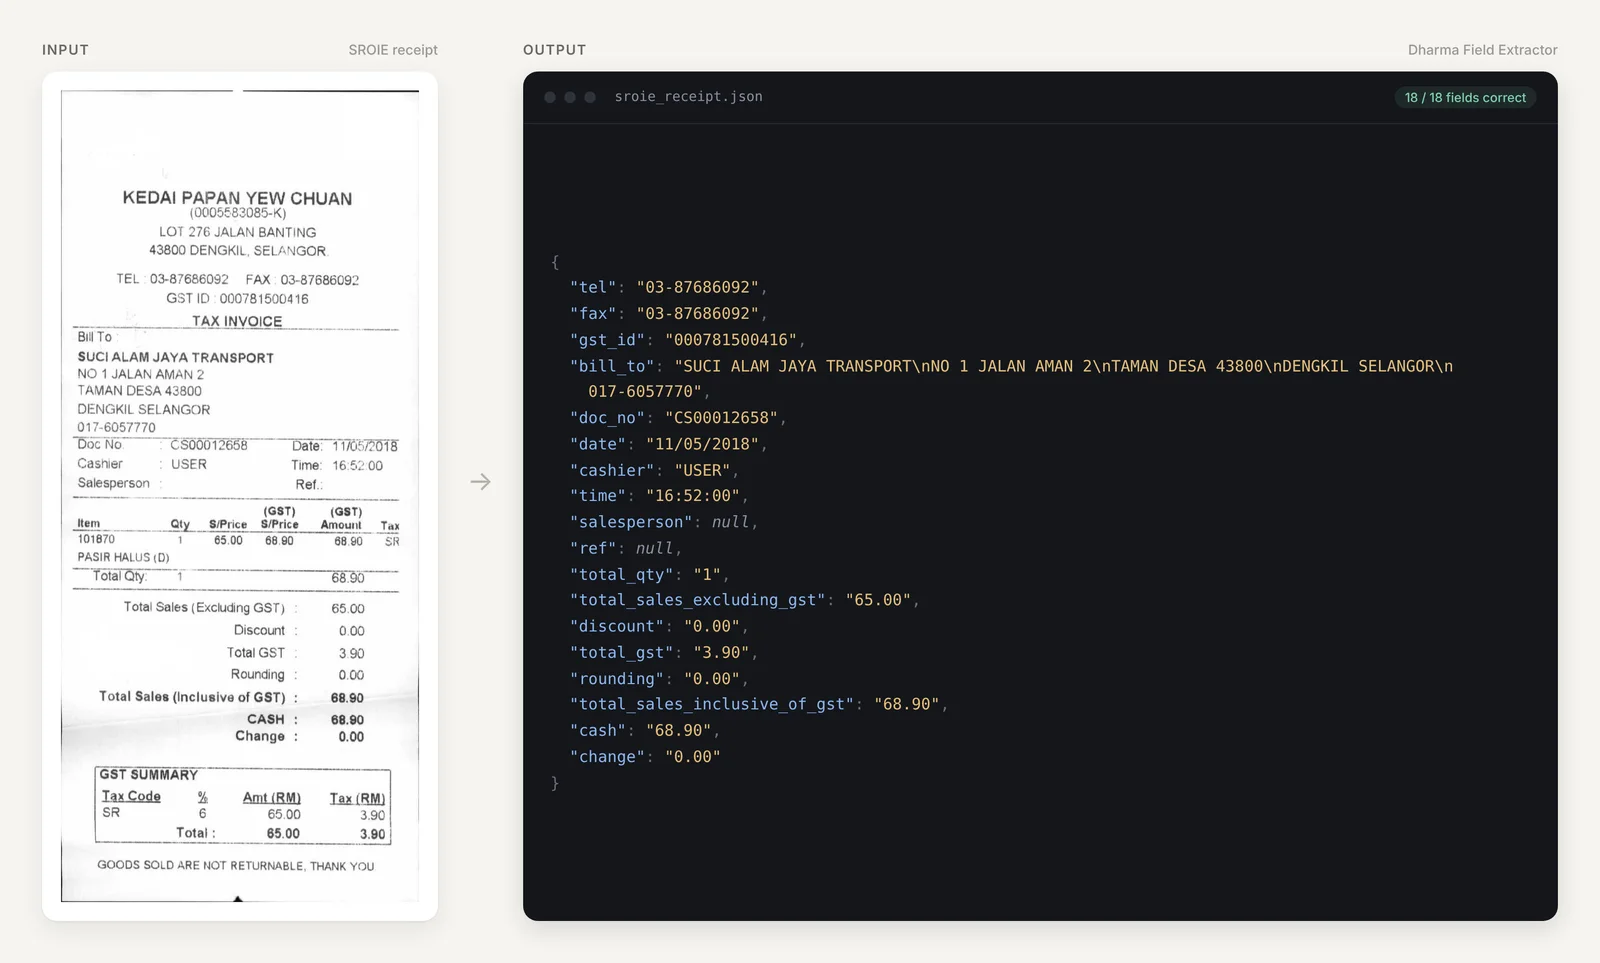
Extracción de 18 campos sobre un recibo del conjunto reservado SROIE con manejo correcto de campos en blanco como null (Hugging Face / Dharma-AI).
En el conjunto FUNSD, se evaluó un formulario de varianza de fotocopiado compuesto por una lista de verificación (checklist) de 12 campos booleanos que incluía un grupo anidado de 5 subopciones. El sistema marcó como true únicamente la casilla seleccionada —correspondiente a un original de baja calidad con la anotación manuscrita «faded»— y asignó false a las otras 11.
Además, el modelo leyó correctamente el identificador manuscrito Bates ID de la página y asignó null a los 2 campos dejados en blanco. Esta combinación de lectura manuscrita, esquemas anidados y manejo estricto de ausencias confirma la transferencia hacia formatos no vistos durante el ajuste con LoRA.
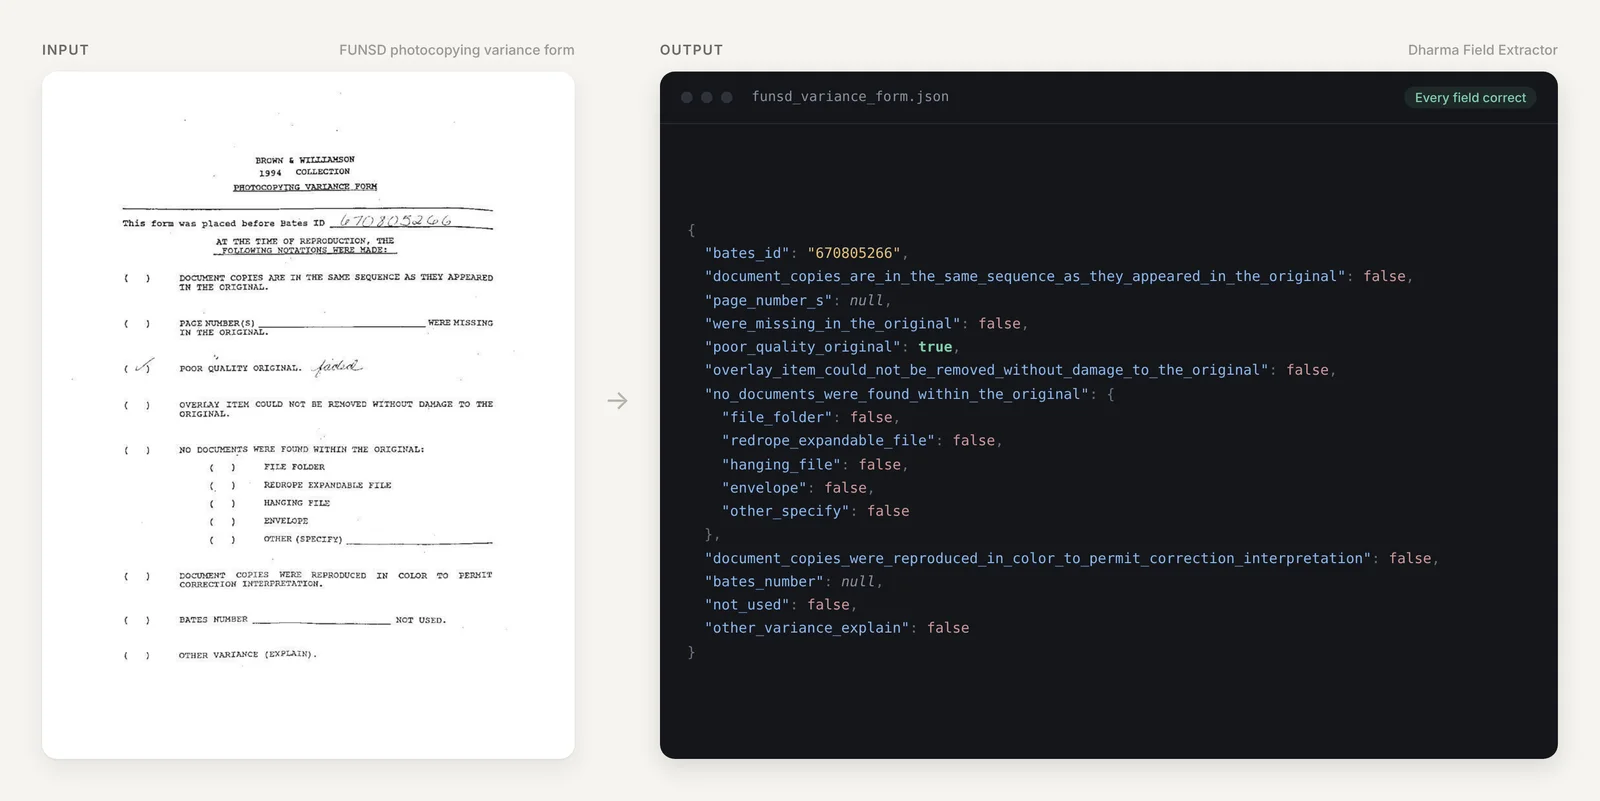
Formulario del conjunto FUNSD con 12 booleanos, grupo anidado de 5 subopciones, anotación manuscrita y lectura de Bates ID (Hugging Face / Dharma-AI).
Conjuntos de referencia y tesis de especialización
La documentación técnica cita 11 conjuntos de datos públicos utilizados entre las fuentes del proyecto y las pruebas reservadas de evaluación, abarcando documentos de identidad brasileños, facturas portuguesas, recibos internacionales y formularios:
| Conjunto de datos | Alcance documental / región | Uso declarado |
|---|---|---|
| BID (Brazilian Identity Document Dataset) | Documentos de identidad de Brasil (2020) | Fuente citada en el proyecto |
| CORD (NAVER CLOVA) | Recibos y documentos estructurados (2019) | Fuente citada en el proyecto |
| DocVQA (ICDAR 2019 / WACV 2021) | Comprensión visual de documentos | Fuente citada en el proyecto |
| WildReceipt (IJCAI 2021) | Recibos en condiciones no controladas | Fuente citada en el proyecto |
| Zenodo Invoices (PT) | Facturas en portugués (NOVA IMS, 2022) | Fuente citada en el proyecto |
line_items / Katanaml Invoices (Donut) | Partidas y facturas estructuradas (2021) | Fuente citada en el proyecto |
| HumynLabs / Tech4Humans BR-Doc | Facturas y documentos brasileños | Fuente citada en el proyecto |
| SROIE (ICDAR 2019) | Recibos comerciales | Exclusivo de evaluación |
| FUNSD (Jaume et al.) | Formularios escaneados con anotaciones | Exclusivo de evaluación |
Tres meses después de que el primer DharmaOCR-LITE de 3.000 millones de parámetros superara a las APIs comerciales en portugués brasileño y pese a la llegada de modelos más recientes, la ventaja de especialización se mantiene ahora con 2.000 millones de parámetros. Según resume el equipo de desarrollo: «La cantidad de parámetros fija el techo; el entrenamiento decide cuánto de ese techo alcanza un modelo en tu tarea».
Los interesados pueden probar la extracción en el portal web de Dharma-AI o consultar los demos interactivos en la página de Dharma AI en Hugging Face y en dharma-ai.com. Con este lanzamiento, la firma sostiene que una empresa no necesita el modelo más grande disponible, sino uno entrenado específicamente para su problema y desplegable bajo control propio.
Fuente: Dharma Field Extractor: Any Document In, Structured Fields in JSON Out