Inkling 2 Mini: el modelo MoE en bucle de Thinking Machines Lab que activa 3.000 millones de parámetros para IA local
Thinking Machines Lab lanza Inkling 2 Mini, un modelo MoE multimodal con núcleo en bucle, 3.000 millones de parámetros activos y ventana de 1M de tokens.
El laboratorio de inteligencia artificial Thinking Machines Lab ha lanzado Inkling 2 Mini, un nuevo modelo transformer multimodal diseñado específicamente para ejecutarse en equipos locales con alta eficiencia de memoria. Según detalla el comunicado técnico publicado en el blog oficial de Hugging Face por los investigadores Merve Noyan, Pedro Cuenca, Aritra Roy Gosthipaty y Guarin Flück, esta versión reduce drásticamente el tamaño respecto a su hermano mayor, Inkling 2 Small, manteniendo un rendimiento competitivo frente a alternativas de mayor tamaño.
El modelo se basa en una arquitectura de mezcla de expertos (Mixture-of-Experts o MoE) que procesa entradas tanto de texto como de imagen y soporta una ventana de contexto de hasta un millón de tokens. Su principal innovación reside en un diseño de capas en bucle (looped transformer) que reutiliza los pesos centrales durante tres pasadas consecutivas, lo que le permite operar con la profundidad lógica de un modelo del doble de capas físicas sin penalizar el almacenamiento del checkpoint.
Thinking Machines Lab distribuye el modelo oficial (Inkling-2-Mini) en un formato nativo de precisión mixta que combina pesos de expertos en NVFP4 y MXFP8, acompañado de un módulo borrador (drafter) denominado DSpark para acelerar la generación mediante decodificación especulativa. Desde su primer día de disponibilidad, cuenta con soporte directo en transformers, llama.cpp (incluyendo Llama App), MLX para ordenadores Apple Silicon y SGLang para despliegues en centros de datos.
Arquitectura en bucle: de 24 capas físicas a 48 visitas lógicas
A diferencia de los modelos MoE convencionales donde cada capa posee sus propios pesos independientes, Inkling 2 Mini cuenta con 24 capas decodificadoras físicas, pero ejecuta su núcleo central de 12 capas tres veces seguidas en un bucle. De este modo, el decodificador recorre las capas iniciales una sola vez, itera tres veces sobre el bloque intermedio reutilizando exactamente los mismos pesos y finaliza con una pasada única por el bloque de salida, completando el equivalente a 48 capas lógicas por cada token generado.
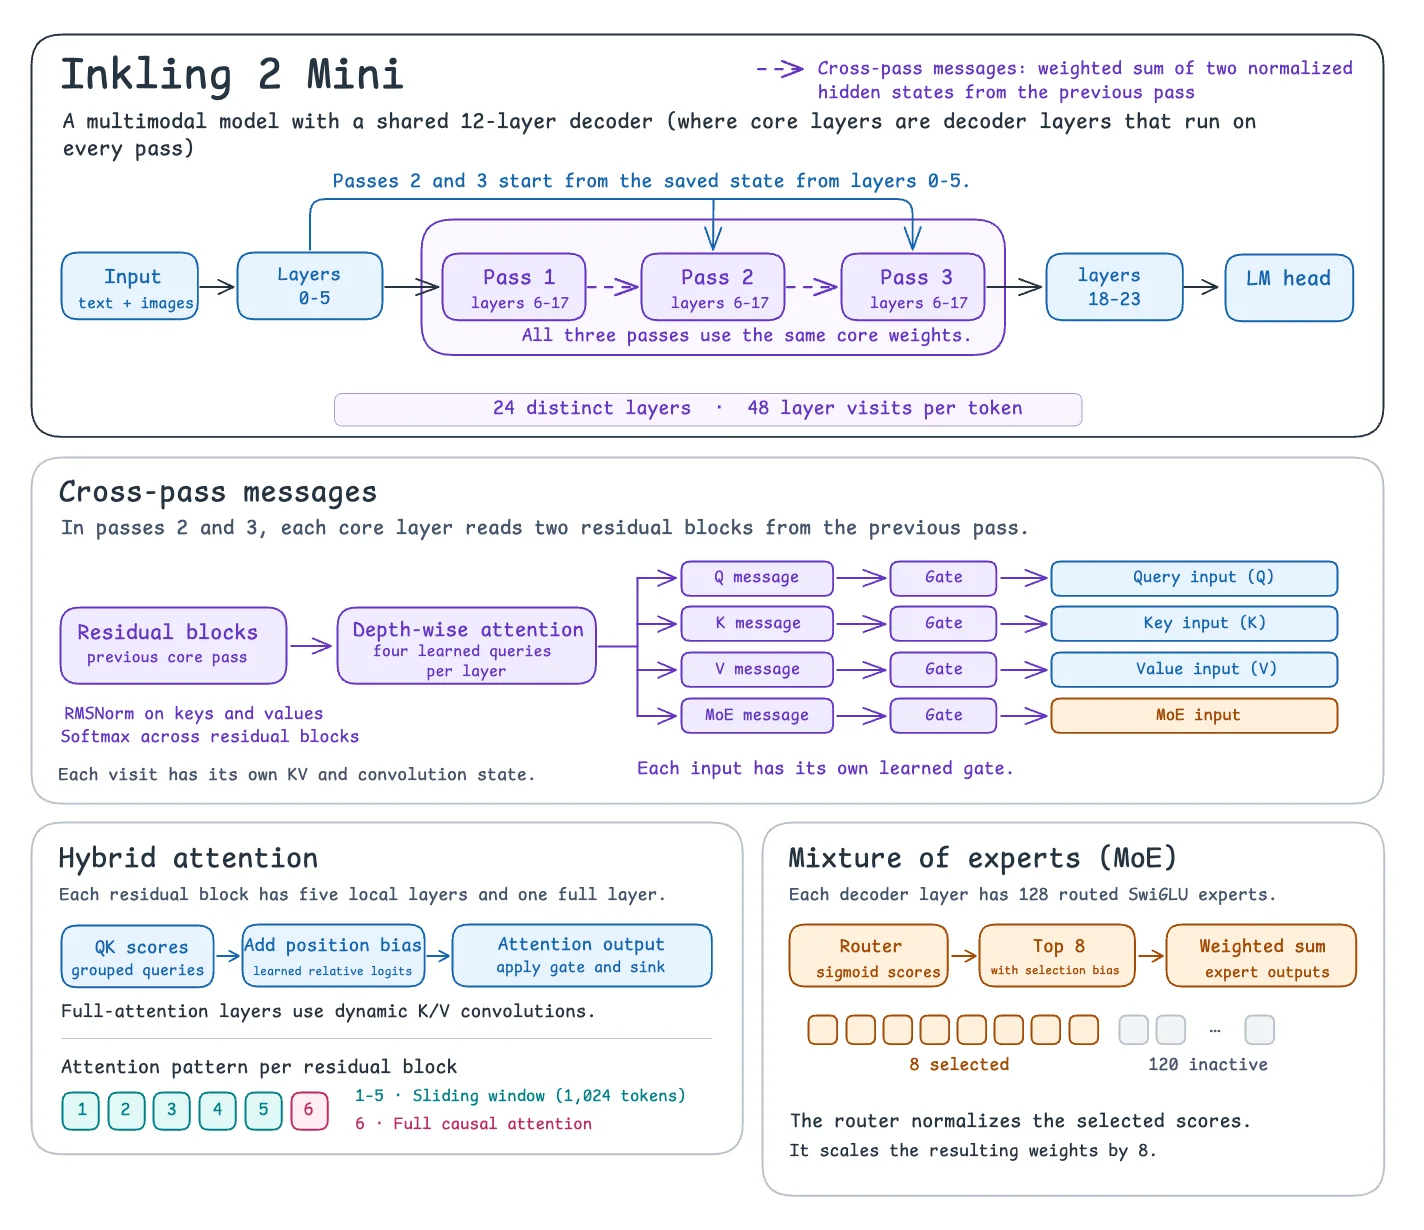
Aunque arquitecturas previas como Nanbeige ya habían explorado la repetición de capas, Thinking Machines Lab introduce un mecanismo de comunicación entre iteraciones basado en mensajes cruzados (cross-pass messages). En lugar de encadenar la salida final del bucle directamente como única entrada de la siguiente vuelta, cada una de las tres pasadas por el núcleo central parte de la misma entrada original generada por las primeras seis capas.
Para transferir y refinar la información entre iteraciones, cada capa en bucle lee un mensaje procedente de las salidas de la pasada anterior utilizando su propia consulta aprendida (learned query), generando mensajes independientes para sus entradas de consulta (query), clave (key), valor (value) y perceptrón multicapa (MLP/MoE). Un controlador de compuertas (gating controller) evalúa simultáneamente la entrada actual y el mensaje previo para decidir qué proporción de la información anterior debe olvidar y cuánto del nuevo mensaje debe incorporar.
Cada bloque de seis capas combina cinco capas de atención de ventana deslizante (sliding-window) y una capa de atención completa (full-attention). La atención emplea logits de posición relativa aprendidos, un sumidero aprendido (learned sink) y una compuerta de salida, mientras que las capas de atención completa integran convoluciones dinámicas de clave y valor. Aunque los pesos del núcleo se reutilizan para reducir la huella en memoria, cada una de las 48 visitas mantiene su propio estado de caché KV y de convolución corta.
| Parámetro arquitectónico | Inkling 2 Mini | Inkling 2 Small (referencia) |
|---|---|---|
| Parámetros físicos totales | ~26.000 millones (~26B) | N/E (superior) |
| Parámetros activos por token | 3.000 millones (3B) | N/E |
| Capas físicas / Visitas lógicas | 24 físicas / 48 lógicas (6 + 3×12 + 6) | 48 visitas por token |
| Dimensión oculta (hidden size) | 2.304 (anchura intermedia de experto: 1.152) | 4.608 |
| Enrutamiento de expertos SwiGLU | 8 activos de 128 por capa (escalado ×8) | 8 activos de 384 por capa |
| Cabezales de atención | 24 de consulta (query) / 8 KV | N/E |
| Ventana de contexto máxima / local | 1.000.000 de tokens / 1.024 tokens (local) | N/E |
| Compuertas entre pasadas (2 y 3) | Atención sobre 2 bloques residuales previos con 4 compuertas de rango 64 | N/E |
| Formato de pesos nativo | Precisión mixta NVFP4 y MXFP8 + borrador DSpark (3 capas) | N/E |
Junto al modelo principal de bucle fijo (3 pasadas), el laboratorio ha publicado un artefacto experimental de investigación identificado como thinkingmachines/TML-d24-varloop-research. Esta variante comparte la misma estructura, pero fue entrenada para aceptar un número variable de pasadas por el bucle (loop_num_passes). Reducir la configuración a 1 o 2 iteraciones acelera notablemente la inferencia en equipos limitados a cambio de una ligera reducción en la calidad de las respuestas.
Rendimiento frente a Qwen 3.8 27B y Gemma 4 31B
En las evaluaciones estandarizadas, Inkling 2 Mini se posiciona como líder de su categoría dentro del índice Artificial Analysis Intelligence Index v5 (AAv5). Al compararlo directamente frente a cuatro modelos de referencia de escala similar —Gemma 4 31B, Muse Glimmer, Qwen3.8-27B y Nemotron 3.5 Super VL—, la propuesta de Thinking Machines Lab ocupa el primer lugar en 32 de los 48 benchmarks analizados.
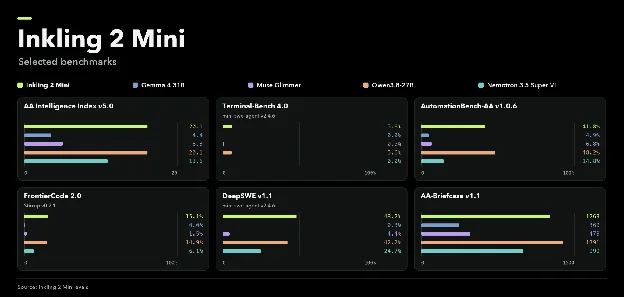
Las pruebas abarcan cinco grandes áreas: programación e investigación autónoma (autoresearch), búsqueda agéntica y uso de herramientas para trabajo de conocimiento, interpretación y creación visual, razonamiento general, así como seguridad y alineamiento. En el apartado específico de asistencia a la programación local, el modelo lidera la prueba FrontierCode v2.0, empata con Qwen3.8-27B en Terminal-Bench 4.0 y se sitúa ligeramente por detrás de Qwen en AutomationBench-AA v1.0.6, además de destacar en la puntuación ELO de AA Briefcase.
Despliegue local, niveles de razonamiento y cuantizaciones GGUF
Para facilitar su adopción en distintos entornos de hardware, la integración en la biblioteca transformers se realiza mediante la clase AutoModelForMultimodalLM y AutoProcessor. El procesador incluye soporte nativo para llamadas a herramientas (tool calling) y permite ajustar dinámicamente el esfuerzo de razonamiento (reasoning effort) en la plantilla de chat antes de generar la respuesta, inyectando el valor numérico como mensaje de sistema.
Nivel de reasoning_effort | Valor numérico asignado | Comportamiento en inferencia |
|---|---|---|
none | 0.0 | Respuesta directa sin cadena de razonamiento extendida |
minimal | 0.1 | Esfuerzo mínimo de reflexión previa |
low | 0.2 | Razonamiento ligero recomendado para llamadas rápidas a herramientas |
medium | 0.7 | Equilibrio entre latencia y análisis intermedio |
high (por defecto) | 0.9 | Nivel predeterminado de alta profundidad analítica |
xhigh / max | 0.99 | Máxima capacidad de evaluación para problemas complejos |
Además de estos perfiles predefinidos, la API acepta cualquier valor decimal personalizado entre 0.0 y 0.99 (por ejemplo, reasoning_effort=0.35). En el caso de usuarios de macOS y Windows que prefieran una ejecución directa, el equipo de llama.cpp ha habilitado compatibilidad completa en Llama App y desde la línea de comandos (llama serve), ofreciendo una API local compatible con OpenAI para conectarlo con editores de código y agentes.
La organización ggml-org distribuye cuantizaciones oficiales en formato GGUF tanto para el modelo estándar (ggml-org/Inkling-2-Mini-GGUF) como para la variante de bucle variable (ggml-org/TML-d24-varloop-research-GGUF), disponibles en precisión de 4 bits (IQ4_NL) y 8 bits (Q8_0). Por su parte, en el ecosistema Apple Silicon, el soporte se ha integrado directamente en el proyecto mlx-lm con versiones cuantizadas en mlx-community; además, MLX es capaz de ejecutar el checkpoint original utilizando el esquema nativo nvfp4 + mxfp8 sin necesidad de reconversión, preservando la fidelidad exacta de los pesos.
Aceleración en SGLang con decodificación especulativa DSpark
Para entornos de producción en servidores, SGLang ofrece soporte desde el día cero sobre arquitecturas con capacidad de cómputo SM103, utilizando el backend de atención fa4, precisión bfloat16, tamaño de página 128 y el motor gramatical xgrammar (con la bandera opcional --enable-multimodal). Su característica más relevante en servidor es la compatibilidad con el algoritmo de decodificación especulativa DSpark (--speculative-algorithm DSPARK con longitud de contexto de 131.072 tokens).
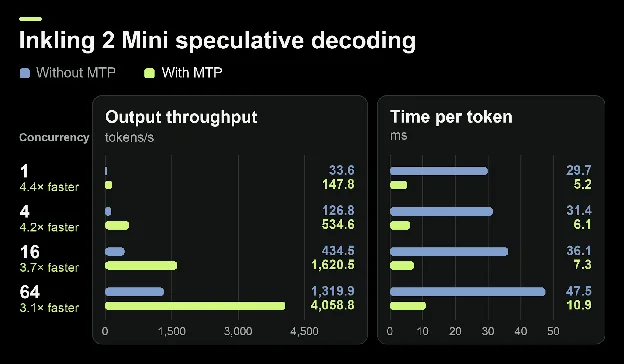
El módulo DSpark es un borrador ligero de tres capas que propone secuencias de tokens para que el modelo principal las verifique en paralelo con un coste mínimo de memoria. Para construir sus predicciones, DSpark lee directamente las entradas correspondientes a las visitas del decodificador número 5, 23 y 41, sumadas al estado final normalizado en el índice 48. En las pruebas de rendimiento ejecutadas sobre una única GPU NVIDIA B300 —procesando peticiones con prompts de 1.024 tokens y salidas exactas de 1.024 tokens bajo niveles de concurrencia de 1, 4, 16 y 64—, la activación de DSpark mejora sustancialmente el caudal de generación (throughput) y reduce el tiempo por token.
Pruebas prácticas: de bocetos en papel y shaders WebGL a agentes web
Para demostrar las capacidades multimodales y de programación autónoma en condiciones reales, el equipo de Hugging Face sometió a Inkling 2 Mini a cinco pruebas prácticas utilizando el entorno de agentes de código Pi:
- Escenarios 3D procedurales en WebGL (Sunset Ridge): A partir de un único prompt compartido con Qwen 3.8 27B, se solicitó un vuelo de cámara cinematográfico a 60 fotogramas por segundo (1920×1080) sobre montañas procedurales, nubes volumétricas y agua reflectante iluminada por un atardecer, todo contenido en un único archivo
index.htmlcon un fragment shader de WebGL sin texturas ni librerías externas. El modelo implementó además un escalado dinámico de resolución para mantener la fluidez e inspeccionó sus propios fotogramas renderizados en Chrome sin cabeza (headless). - Recreación animada de La noche estrellada: Tomando como entrada visual el cuadro original de Vincent van Gogh de 1889, el modelo escribió desde cero un shader en WebGL2 que anima de forma procedural las espirales del cielo, el parpadeo de las estrellas, el balanceo del ciprés y las luces del pueblo sin cargar la imagen original. El agente iteró y corrigió su propio código a lo largo de 24 rondas de verificación visual mediante capturas de pantalla, logrando una animación fluida a 1080p y 60 fps grabada en un chip Apple M4 Max.
- De un boceto en servilleta a una aplicación funcional (Napkin to App): Tras recibir únicamente la fotografía de un esquema dibujado a mano con anotaciones en rojo para una aplicación de división de gastos de viaje (Trip Split), Inkling 2 Mini construyó la aplicación completa en un solo archivo con HTML, CSS y JavaScript puro, incluyendo persistencia en
localStoragey cálculo automático de deudas. Al evaluar tres intentos independientes mediante pruebas automatizadas con Playwright, el primer intento superó las 13 verificaciones funcionales, recalculando correctamente el gasto total de 405 a 495 dólares tras añadir una cena de 90 dólares indicada en el papel. - Generación autónoma en 4 bits (
IQ4_NL): Incluso utilizando la versión comprimida a 4 bits en GGUF y un prompt de una sola frase, el modelo diseñó de forma autónoma una plataforma web para un servicio ficticio (Plant Therapy) que empareja plantas domésticas con terapeutas, generando sus propias ilustraciones vectoriales en formato SVG y toda la lógica interactiva de emparejamiento en un único documento HTML. - Autoconstrucción de un agente de navegador: En combinación con el agente de programación Pi, Inkling 2 Mini fue capaz de programarse a sí mismo para operar como un agente de navegación web funcional apoyándose en Helium, Chromium y los entornos aislados de Hugging Face Sandboxes.
Fuente: Hugging Face