OpenAI revela que sus investigadores valoran más a sus agentes de IA que a casi la mitad de sus colegas
Investigadores de OpenAI prefieren sus agentes de IA antes que al 40 % de su equipo, aunque los modelos aún fallan en ingeniería compleja.
OpenAI revela que sus investigadores valoran más a sus agentes de IA que a casi la mitad de sus colegas
Los investigadores de OpenAI dependen cada vez más de herramientas internas como Codex y Dots para acelerar el desarrollo de nuevos modelos. Según recoge The Decoder, el uso intensivo de agentes de programación ha crecido hasta alcanzar un coste teórico en tokens que ya supera los salarios base del personal científico.
La compañía ha publicado estos datos en su segundo informe sobre aceleración interna de la investigación, cuyo objetivo es documentar indicadores de la llamada mejora recursiva propia (RSI, por sus siglas en inglés). Este fenómeno describe el punto en el que los sistemas de inteligencia artificial aceleran de forma directa el desarrollo de sus generaciones futuras.
Consumo de cómputo y jornadas equivalentes en Codex y Dots
Durante octubre, el investigador mediano consumió el equivalente a 2.400 dólares diarios en tokens calculados a precios estándar de API, lo que supone un incremento del 62 % respecto al mes anterior. Entre el 10 % de los usuarios más activos, ese valor teórico se duplicó hasta alcanzar los 23.000 dólares al día.
Convertido a jornadas laborales de ocho horas, los agentes ejecutaron el equivalente a 5,7 días de trabajo por investigador cada día natural, cifra que asciende a unos ocho días en los equipos de pretraining y post-training. Más de dos tercios de los investigadores monitorizados operaron al menos cuatro agentes en paralelo durante los picos de actividad.
En septiembre, el equivalente teórico en API de ese tiempo de ejecución duplicó el coste de los salarios regulares de los investigadores. No obstante, ese cálculo excluye los paquetes de compensación en acciones (equity), que representan entre el 70 % y el 80 % de la remuneración total en OpenAI, y el uso interno de agentes apenas supuso el 2 % del cómputo total de investigación de la empresa.
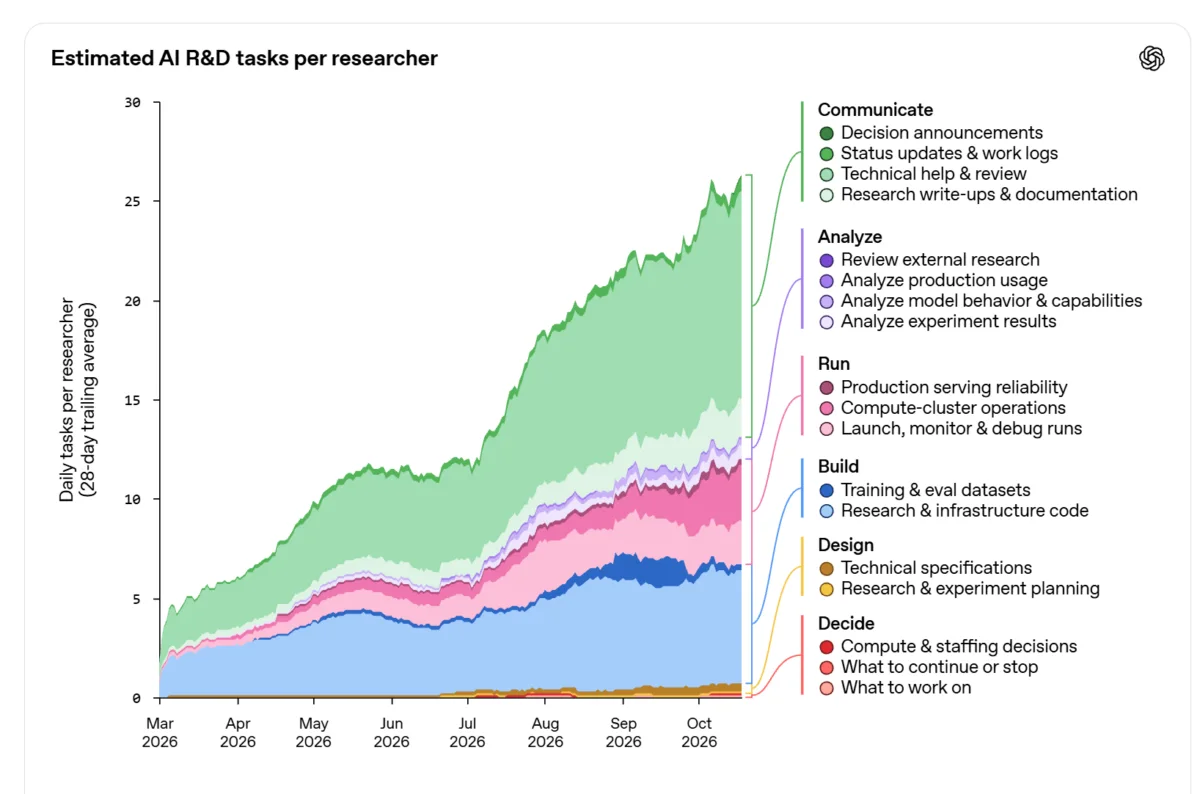
Una gran proporción del uso interno de IA se destina a comunicación y programación. Imagen: OpenAI.
Éxito en tareas rutinarias frente a los límites de la ingeniería compleja
Entre marzo y octubre, la tasa estimada de éxito de los agentes autónomos sin intervención humana mejoró de forma notable en tareas de varias horas de duración. Sin embargo, un desglose basado en la taxonomía de Epoch AI confirma que los sistemas destacan sobre todo en labores sencillas y mantienen un rendimiento bajo en arquitectura e ingeniería compleja.
| Categoría o duración de la tarea | Tasa de éxito registrada | Evolución o contexto |
|---|---|---|
| Tareas autónomas de 2 a 4 horas | 46 % | Subió desde el 23 % en marzo |
| Tareas autónomas de 4 a 8 horas | 35 % | Subió desde el 13 % en marzo |
| Supervisión de ejecuciones de entrenamiento | 79 % | Tarea rutinaria de alto rendimiento |
| Respuesta independiente a dudas técnicas | 72 % | Alta fiabilidad operativa |
| Creación de entornos de evaluación y aprendizaje por refuerzo | 29 % | Debilidad en ingeniería compleja |
| Código para sistemas de inferencia y servicio | 25 % | Cuello de botella técnico |
A pesar de estas limitaciones, una encuesta interna no representativa entre 101 empleados reveló que la mediana de los investigadores preferiría renunciar al 40 % del personal de su equipo o al 30 % de su capacidad de cómputo antes que pasar tres meses sin sus agentes de programación actuales. En otro sondeo rápido a 28 trabajadores, 27 prefirieron el modelo interno más reciente frente a un ingeniero humano de nivel intermedio.
La falta de criterio científico exige supervisión humana
Las entrevistas cualitativas realizadas a diez investigadores ponen de relieve el reverso de esta adopción masiva. Según los participantes, los modelos carecen de «gusto» o criterio para identificar buenas ideas de investigación y garantizar la calidad del código y los datos.
En la práctica, los agentes se pierden en pasos innecesarios, asumen premisas erróneas en los análisis y envían cambios de código deficientes —descritos como «AI slop»— junto con artefactos de datos inutilizables. Por ello, los equipos subrayan que una supervisión humana estrecha resulta indispensable para evitar el desperdicio de ciclos de cómputo.
Las ideas conceptuales clave para GPT-6 Astra y GPT-6.2 Astra procedieron exclusivamente de investigadores humanos en las áreas de post-training y seguridad. Solo durante el pretraining de GPT-6.2 Astra algunos científicos señalaron haber obtenido perspectivas relevantes mediante el diálogo con Codex.
Riesgos de aceleración y precedentes en la industria
OpenAI advierte en sus conclusiones que los datos recopilados hasta ahora sobre la colaboración entre humanos e inteligencia artificial podrían no extrapolarse de forma lineal. La empresa cita los recientes avances abruptos en matemáticas como muestra de que podrían producirse saltos similares en la propia investigación de aprendizaje profundo a medida que los modelos ganen autonomía.
Este debate coincide con estimaciones recientes de la organización de evaluación METR, que tras analizar durante once semanas el trabajo interno en Anthropic calculó que el uso de IA casi había duplicado allí el ritmo de desarrollo. Previamente, en su primer informe de principios de septiembre, OpenAI ya había dado por cumplido su objetivo de contar con un «becario de investigación» automatizado, mientras su científico jefe, Jakub Pachocki, alertaba sobre los riesgos de perder el control tras detectarse lagunas en la monitorización de seguridad.
Fuente: The Decoder