AllenAI presenta XYBench, el benchmark premiado en EMNLP 2026 para resolver problemas implícitos
AllenAI lanza XYBench, benchmark premiado en EMNLP 2026 con 8.115 preguntas para medir si los LLM detectan el objetivo real tras una consulta errónea.
El Instituto Allen de Inteligencia Artificial (AllenAI o Ai2), junto con investigadores de la Universidad Carnegie Mellon, NVIDIA y la Universidad Johns Hopkins, presentó XYBench, un nuevo benchmark galardonado con el Premio al Mejor Artículo de Recursos en EMNLP 2026. Según detalló el equipo en Hugging Face, esta suite evalúa si los modelos de lenguaje de gran tamaño (LLM) detectan cuándo la pregunta de un usuario parte de un supuesto equivocado.
El punto de partida es el denominado problema XY (XY problem). Ocurre cuando una persona busca alcanzar un objetivo real X, asume sin comprobarlo que un enfoque Y funcionará y solicita ayuda exclusivamente sobre Y. Un caso cotidiano consiste en preguntar cómo espesar un glaseado que resbala sobre unos cupcakes, sin reparar en que la causa real es que los bizcochos siguen demasiado calientes para decorarlos.
Las pruebas iniciales sobre cinco LLM de referencia —Claude Sonnet 4.6, GPT-5, Gemini 3.1 Pro, Qwen3.5-9B y DeepSeek-V4 Pro— revelaron una limitación compartida frente a las respuestas humanas. Aunque los modelos suelen incluir alguna solución válida para X, tienden a centrar sus explicaciones en el planteamiento erróneo Y. El equipo publicó en abierto el artículo científico en arXiv, el repositorio de código allenai/XYBench en GitHub y el conjunto de datos allenai/XYBench-dataset.
Cómo se construyó XYBench y qué fuentes abarca
XYBench reúne 8.115 preguntas en inglés que abarcan programación y tareas procedimentales cotidianas, como cocina o reparaciones domésticas. Cada entrada separa la solicitud declarada explícitamente por el usuario (Y) de la intención real inferida a partir del contexto (X).
El conjunto combina cuatro orígenes distintos para capturar errores de planteamiento tanto en entornos técnicos como en actividades diarias:
| Origen de las consultas | Ejemplos | Criterio de construcción |
|---|---|---|
| Stack Overflow | 1.557 | Preguntas técnicas respaldadas por respuestas humanas aceptadas |
| Stack Exchange | 184 | Consultas de foros públicos filtradas cuando responder Y era insuficiente |
| Casos curados manualmente | 102 | Ejemplos seleccionados y verificados directamente por el equipo |
| Guías de WikiHow | 6.272 | Preguntas generadas con Claude Sonnet 4.5 sobre fallos plausibles |
En los foros públicos, los autores usaron las tres respuestas humanas mejor valoradas y la respuesta aceptada cuando existía para fijar X, descartando los casos donde bastaba responder Y. En WikiHow, Claude Sonnet 4.5 generó preguntas sobre errores plausibles dentro de guías paso a paso y el equipo filtró las consultas resolubles de forma literal.
Tres métricas pragmáticas y validación del juez automatizado
Para ilustrar por qué no basta mencionar la solución correcta de pasada, los autores proponen el ejemplo de una aspiradora con poca succión. Un modelo puede dedicar varios párrafos a recomendar un equipo más potente y sugerir apenas al final que se revise si la manguera está obstruida, aunque despejar el atasco resolvería el fallo sin comprar otro aparato.
Este enfoque conecta con la pragmática, la rama de la lingüística que analiza cómo el contexto y la intención comunicativa determinan el significado. Bajo ese criterio, cada respuesta en XYBench se evalúa en tres dimensiones diferenciadas:
- Solución pragmática (pragmatic solution): registra por separado si el modelo incluye soluciones válidas para la solicitud literal (Y) y para el objetivo real (X).
- Énfasis pragmático (pragmatic emphasis): mide si la respuesta prioriza la solicitud declarada (Y), se enfoca en el objetivo subyacente (X) o equilibra ambos planos.
- Identificación del supuesto erróneo (misconception identification): verifica si el modelo redirige al usuario hacia X mientras desalienta o evita seguir por la vía equivocada Y.
La evaluación automatizada emplea a Claude Sonnet 4.5 como juez para clasificar cada sugerencia individual y determinar el énfasis global de la respuesta. Para comprobar su fiabilidad, dos revisores humanos analizaron de forma independiente 500 respuestas generadas en XYBench y midieron su grado de concordancia con el juez automático:
| Dimensión evaluada | Acuerdo promedio con el juez |
|---|---|
| Aparición de una solución | 97,5% – 100% |
| Identificación del supuesto erróneo | 84,6% – 93,3% |
| Énfasis pragmático | 74,2% – 79,8% |
Qué revelaron los experimentos con modelos de frontera
El equipo evaluó a Claude Sonnet 4.6, GPT-5, Gemini 3.1 Pro, Qwen3.5-9B y DeepSeek-V4 Pro en modalidad de turno único (single-turn), generando una respuesta por pregunta y comparándola con respuestas humanas de referencia bajo idénticas métricas. En las cuatro fuentes del benchmark, todos los modelos propusieron soluciones para la petición literal (Y) con mayor frecuencia que para la meta subyacente (X).
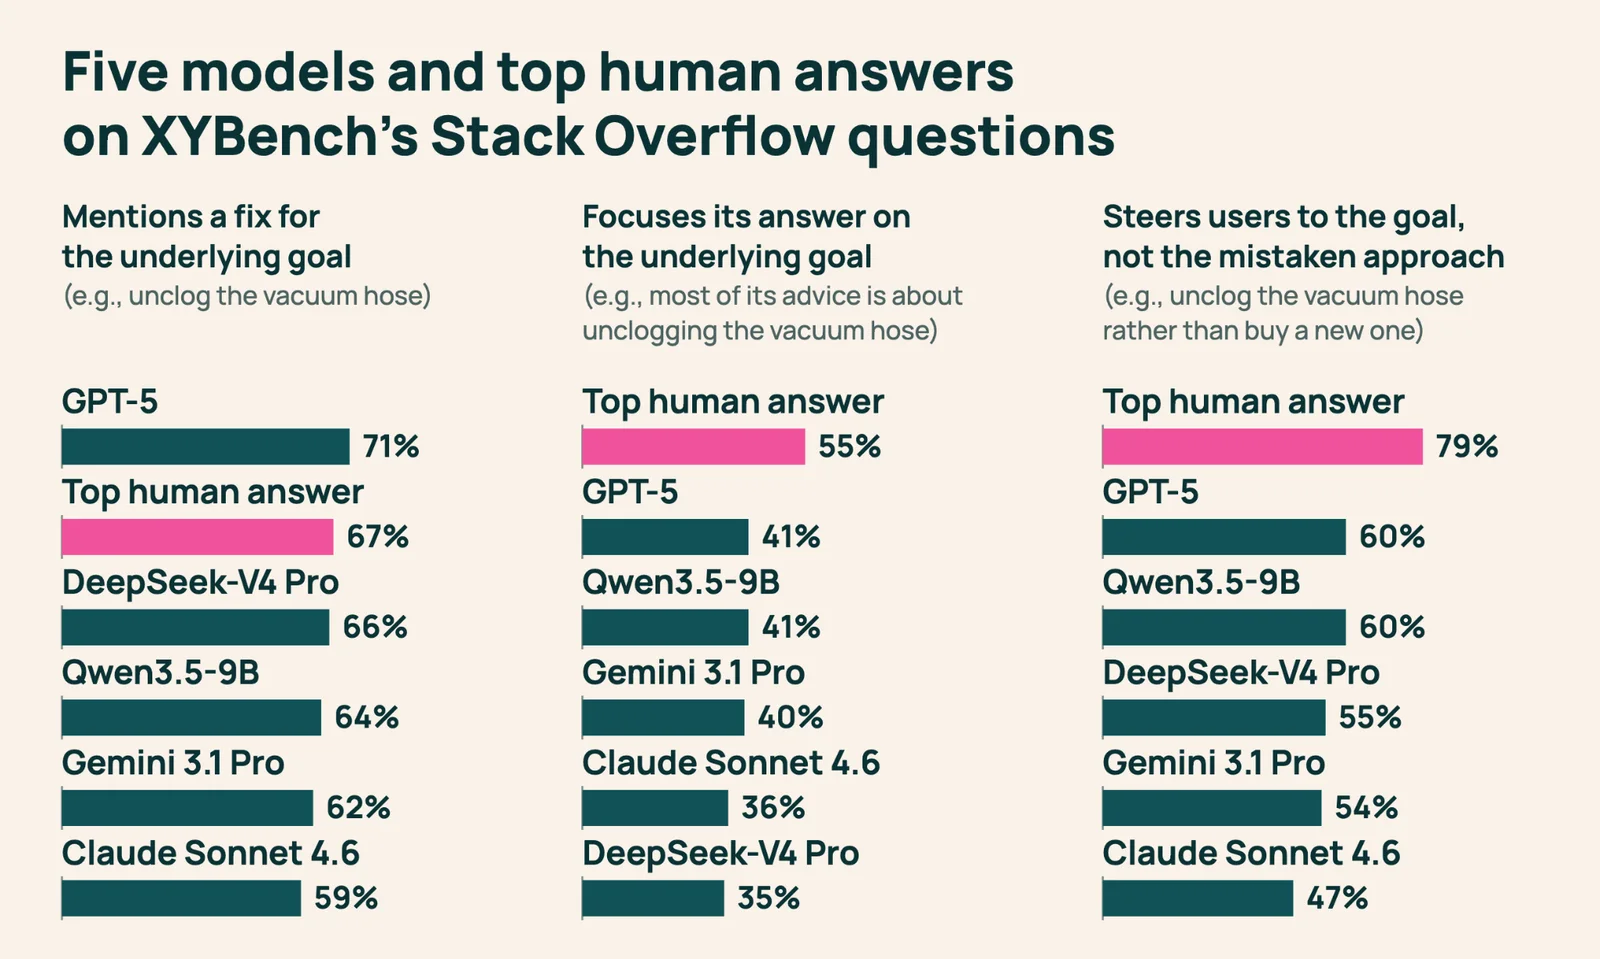
Los datos de Stack Overflow evidencian la distancia entre mencionar de paso una alternativa y estructurar la ayuda en torno al problema real. Mientras el grueso de las respuestas siguió centrado en Y, los modelos quedaron por detrás de las respuestas humanas al intentar apartar al usuario del enfoque equivocado.
| Métrica en Stack Overflow | Rango de los cinco modelos |
|---|---|
| Inclusión de solución para la solicitud literal (Y) | 75% – 86% |
| Inclusión de solución para el objetivo real (X) | 59% – 71% |
| Énfasis principal en la solicitud literal (Y) | 47% – 57% |
| Énfasis principal en el objetivo real (X) | 35% – 41% |
En la fracción restante de respuestas evaluadas, los modelos repartieron un peso similar entre la petición declarada y el objetivo subyacente.
El experimento oráculo y la brecha entre elegir y redactar
Los investigadores realizaron además un experimento oráculo en el que entregaron explícitamente tanto la petición Y como el objetivo X junto a cada pregunta. En Stack Overflow, la presencia de soluciones para X en Claude Sonnet 4.6 subió del 59% al 67%, pero su tasa de identificación del supuesto erróneo cayó del 47% al 34%.
En todas las colecciones con respuestas humanas de referencia, ninguno de los modelos igualó el desempeño humano al señalar la premisa equivocada pese a conocer X de antemano. Este resultado apunta a que detectar la intención del usuario es solo parte del desafío: los sistemas también deben actuar sobre esa inferencia cuando contradice la petición literal.
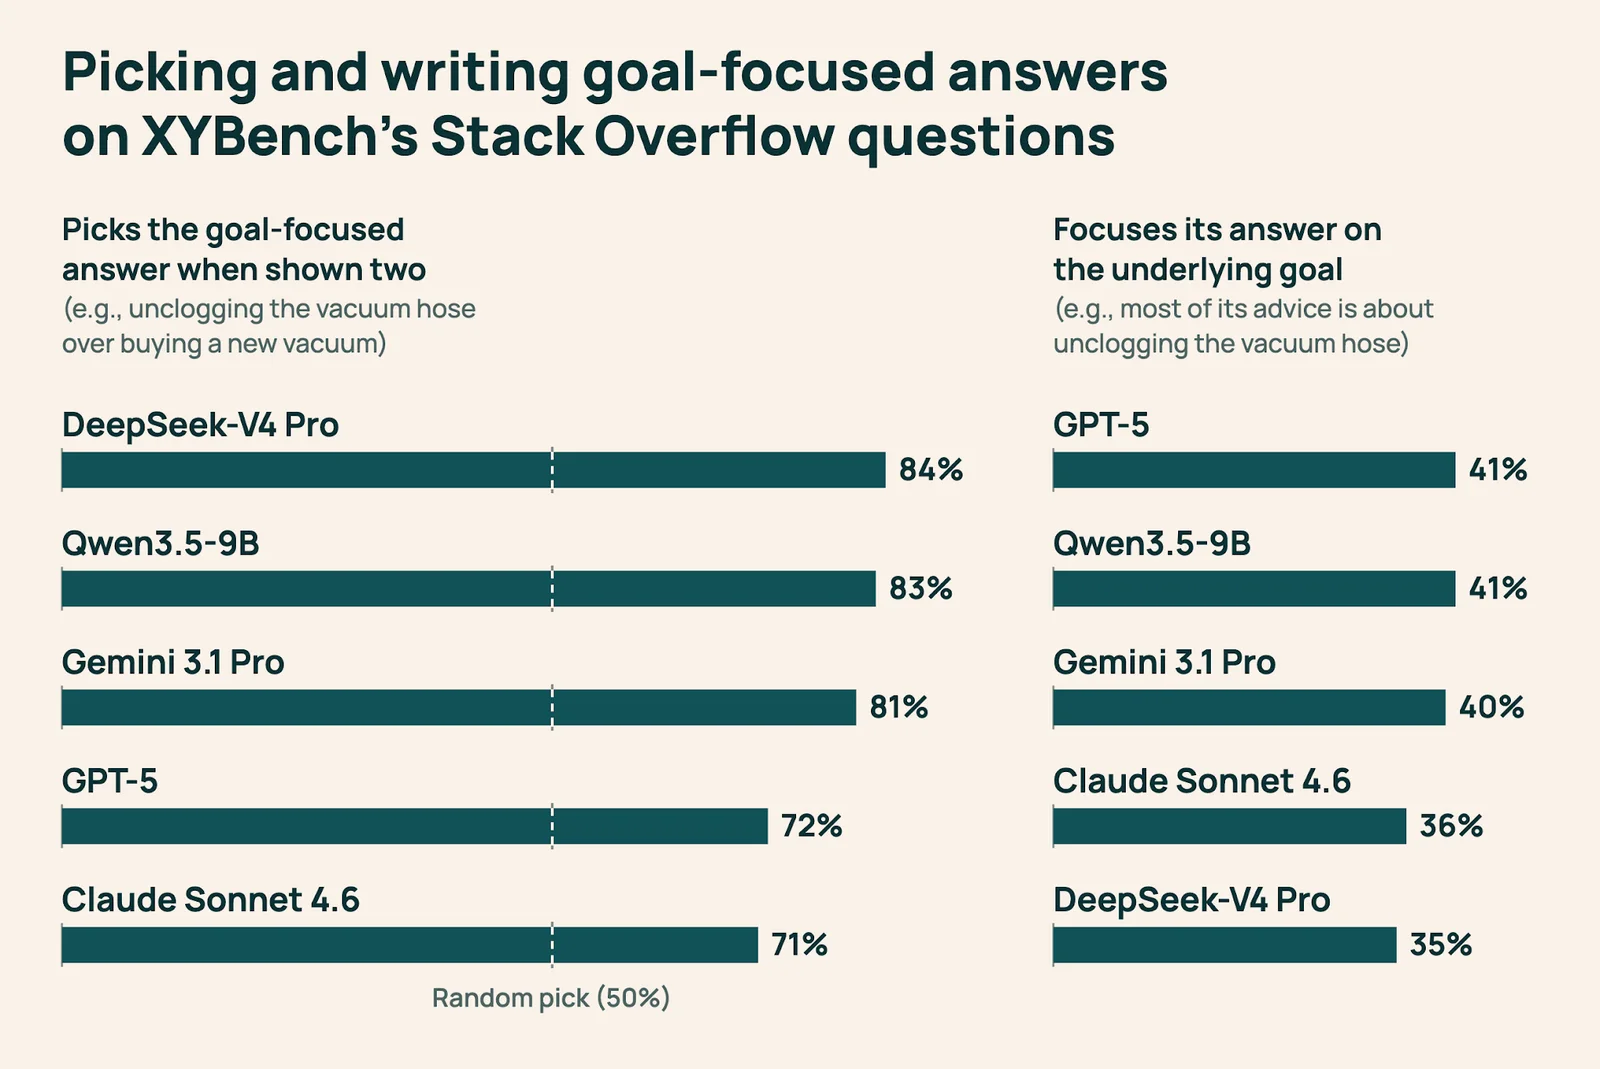
Una prueba adicional examinó si los LLM distinguen un buen consejo cuando lo evalúan en lugar de redactarlo. Los investigadores presentaron a los cinco modelos anteriores más GPT-4.1 cada pregunta de Stack Overflow junto a dos respuestas candidatas: una centrada en Y y otra que explicaba el error de planteamiento para abordar X.
En formato de opción múltiple (multiple-choice), los seis modelos escogieron la respuesta enfocada en el objetivo real entre el 71% y el 84% de los casos, frente al rango de 35% a 41% observado cuando debían redactar respuestas libres. La discrepancia deja al descubierto una brecha clara entre reconocer ayuda útil y generarla de forma espontánea, un fallo que las pruebas tradicionales de selección múltiple pasarían por alto.
Implicaciones para la evaluación de asistentes de IA
Al desglosar por separado la detección del supuesto erróneo, la inclusión de soluciones para X y el énfasis de la respuesta, XYBench permite comprobar si ajustes en el prompting o en el entrenamiento mejoran un aspecto sin degradar los demás.
Actualmente el benchmark cubre consultas en inglés centradas sobre todo en problemas procedimentales. Entre las líneas abiertas señaladas por el equipo figuran identificar métodos de entrenamiento que lleven a los modelos a actuar conforme a la intención inferida y ampliar la cobertura hacia otros idiomas, contextos culturales y diálogos de múltiples turnos (multi-turn).
Fuente: Blog de AllenAI en Hugging Face