Tether AI presenta BotPsy: asistente agéntico local de 800 millones de parámetros para uso de herramientas
Tether AI presenta BotPsy bajo Apache 2.0: un modelo agéntico local de 800 millones de parámetros que lidera cinco de seis benchmarks de herramientas.
Tether Data, S.A. de C.V. —que opera bajo el nombre «Tether AI Research»— ha presentado BotPsy, un modelo de lenguaje agéntico (agentic) de 800 millones de parámetros diseñado para ejecutarse directamente en el dispositivo (on-device). Construido sobre Qwen3.5-0.8B, el sistema prioriza la ejecución de herramientas (function calling) en flujos locales para proteger la privacidad de los datos y evitar la dependencia de servidores externos.
Según detalla el equipo investigador en el blog de Hugging Face, los grandes modelos en la nube implican costes operativos variables, riesgos de retirada o modificación de acceso y menor control sobre el flujo de trabajo. Frente a ese escenario, BotPsy apunta a tareas cotidianas de dificultad baja a media con un tamaño compacto apto para autoalojamiento.
El modelo se publica con pesos abiertos (open weights) bajo licencia Apache 2.0 para investigación y uso educativo, tanto en formato safetensors en qvac/BotPsy-0.8B como en archivos GGUF en las precisiones bf16, Q8 y Q4 en qvac/BotPsy-0.8B-GGUFs para su despliegue con QVAC SDK y llama.cpp.
Entrenamiento en cuatro etapas con destilación y aprendizaje por refuerzo
Para especializar Qwen3.5-0.8B sin erosionar sus capacidades generales, el equipo aplicó un postentrenamiento secuencial en cuatro etapas. Cada fase parte del mejor punto de control (checkpoint) obtenido en la anterior y combina tres señales distintas: trayectorias de demostración, destilación desde modelos docentes y recompensas verificables por reglas.
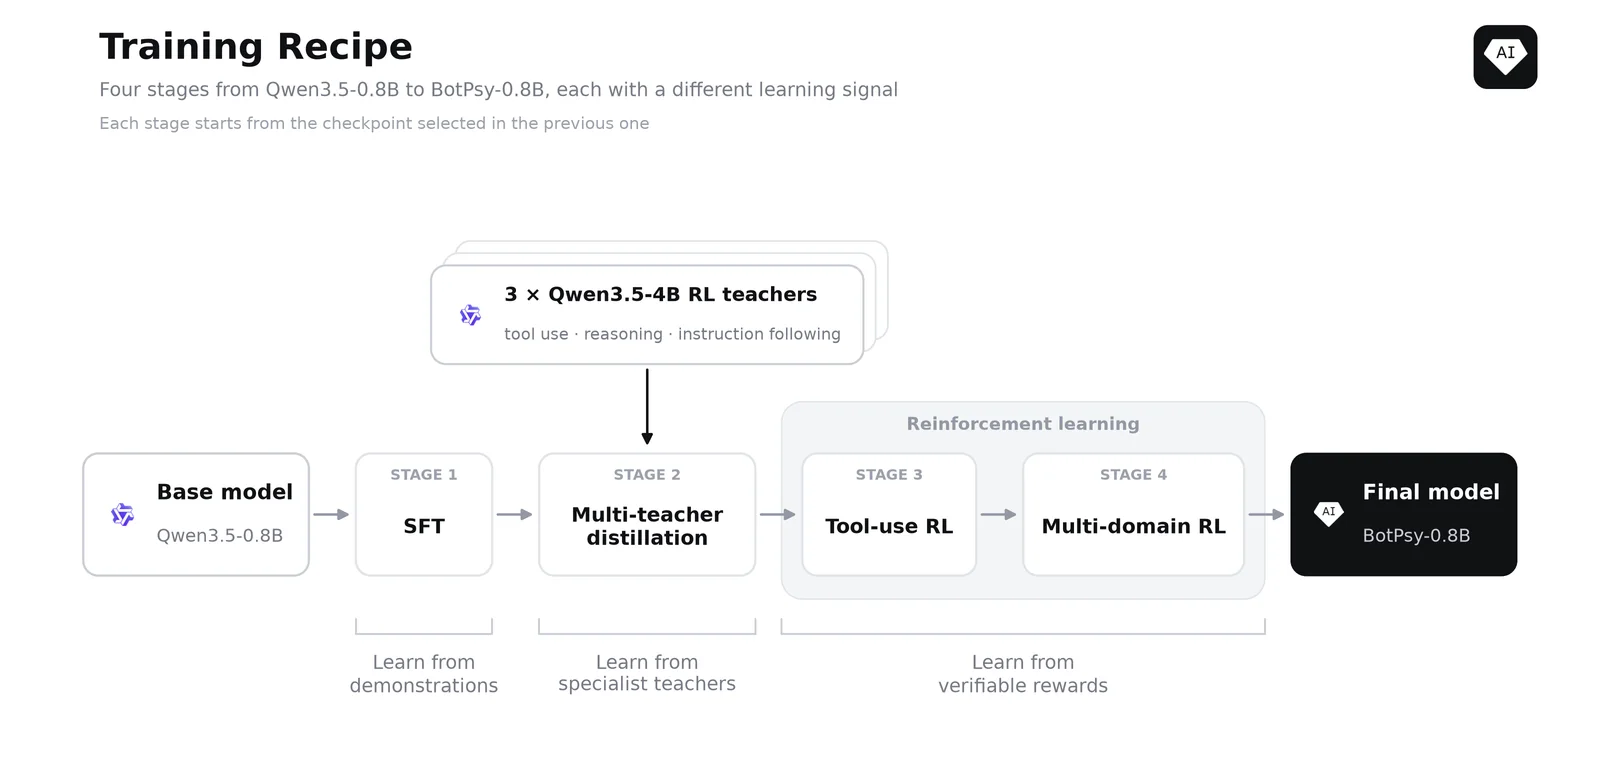
Receta de postentrenamiento de BotPsy en cuatro etapas con tres modelos docentes especialistas Qwen3.5-4B (Hugging Face / Tether AI Research).
El proceso comienza con un ajuste fino supervisado (supervised fine-tuning o SFT) de parámetros completos sobre conversaciones de uso de herramientas. Esta mezcla inicial abarca trayectorias agénticas multiturno en entornos simulados, llamadas simples, paralelas y multipaso repetidas, así como casos en los que el asistente no debe invocar ninguna función.
Dado que el SFT degrada el conocimiento y el seguimiento de instrucciones respecto al modelo base, la segunda etapa aplica destilación multidocente sobre política (Multi-teacher On-Policy Distillation o MOPD). El estudiante genera sus propias respuestas y recibe retroalimentación por token —mediante divergencia KL inversa— desde tres modelos Qwen3.5-4B entrenados previamente con aprendizaje por refuerzo (RL) en uso de herramientas, razonamiento general y seguimiento de instrucciones.
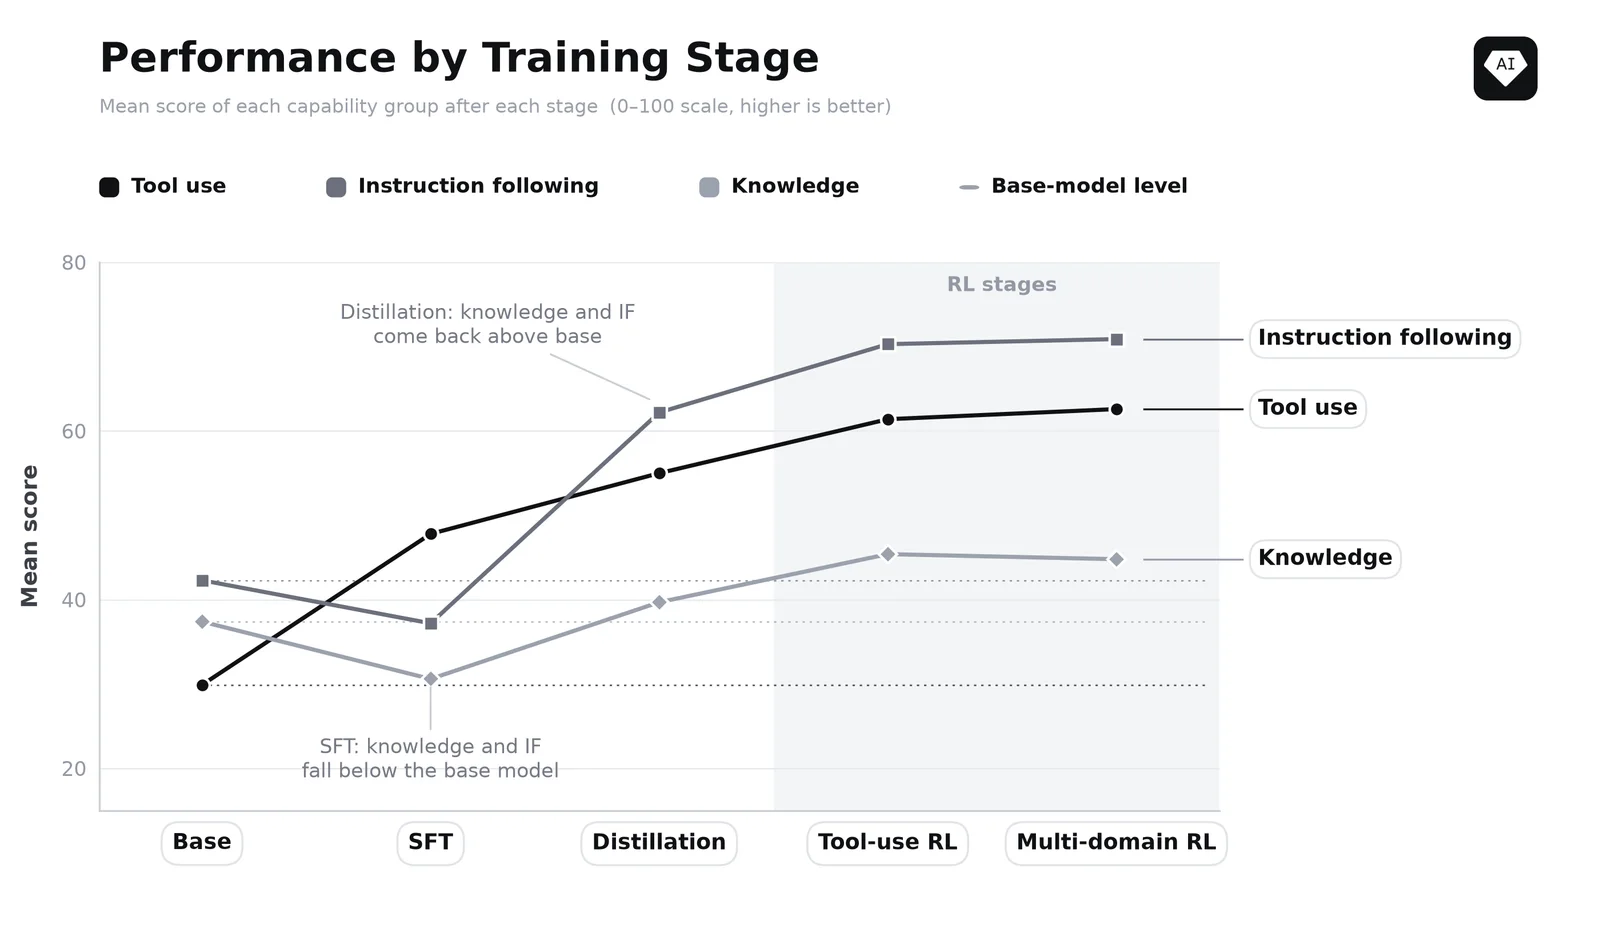
Evolución promedio por grupo de capacidades tras cada etapa: la destilación MOPD recupera el conocimiento y el seguimiento de instrucciones perdidos en el SFT antes de las mejoras finales por refuerzo (Hugging Face / Tether AI Research).
Las dos rondas finales recurren al algoritmo DAPO utilizando únicamente recompensas calculadas por reglas y verificadores. La primera ronda prioriza la invocación de herramientas junto con instrucciones y preguntas STEM de opción múltiple, comprobando primero el formato de razonamiento y llamada como en Tool-N1, pero aplicando crédito parcial granular al estilo de ToolRL según nombres de herramienta, argumentos y valores frente a la referencia (ground truth).
La segunda ronda de RL amplía la mezcla hacia tareas verificables de dominio general: matemáticas, código, conocimiento de opción múltiple, salidas estructuradas, seguimiento de instrucciones y uso multipaso de herramientas en un entorno laboral simulado. Aunque omite diálogos multiturno explícitos, esta etapa mejora adicionalmente el desempeño en conversaciones de múltiples turnos.
Resultados en benchmarks agénticos y comparación de tamaño
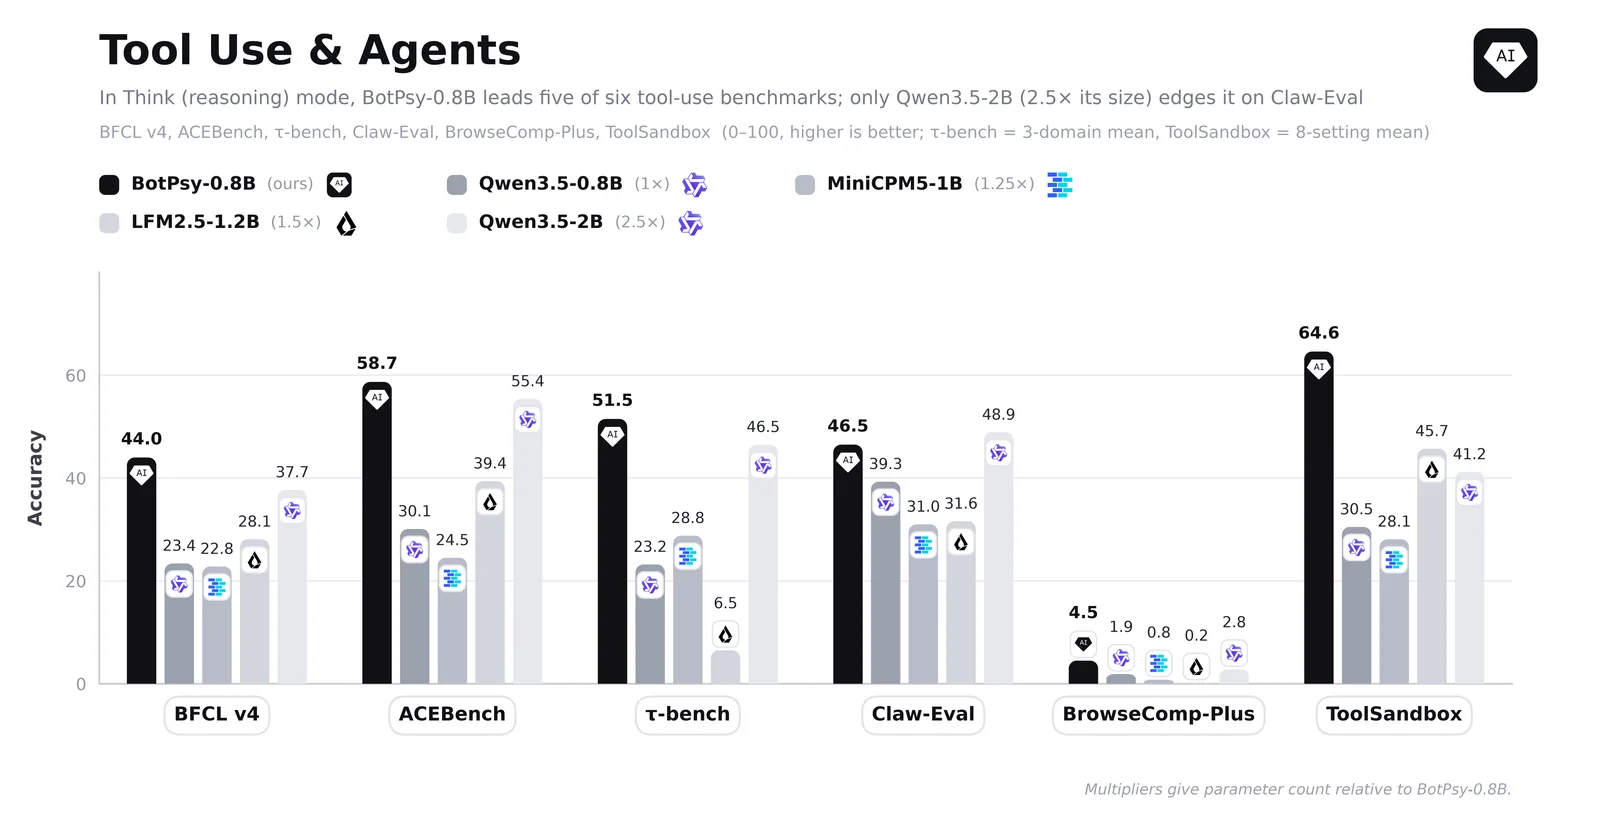
Todas las pruebas se evaluaron con el modo de razonamiento (thinking mode) activado, y los benchmarks con API externas se ejecutaron el 3 de noviembre de 2026. En uso de herramientas y flujos agénticos, BotPsy-0.8B prácticamente duplica el promedio de su modelo base y supera a todos los competidores evaluados de hasta 1.200 millones de parámetros.
Frente a Qwen3.5-2B-Think —un modelo de 2.000 millones de parámetros, equivalente a 2,5× su tamaño—, BotPsy encabeza cinco de los seis benchmarks agénticos. El modelo mayor solo conserva la delantera en Claw-Eval, aunque BotPsy también registra un avance claro sobre su punto de partida.
| Benchmark | BotPsy-0.8B | Qwen3.5-0.8B-Think (base · 1×) | Qwen3.5-2B-Think (2,5×) | LFM2.5-1.2B-Think (1,5×) | MiniCPM5-1B-Think (1,25×) |
|---|---|---|---|---|---|
| BFCL v4 | 44,0 | 23,4 | 37,7 | 28,1 | 22,8 |
| ACEBench | 58,7 | 30,1 | 55,4 | 39,4 | 24,5 |
| τ-bench | 51,5 | 23,2 | 46,5 | 6,5 | 28,8 |
| Claw-Eval | 46,5 | 39,3 | 48,9 | 31,6 | 31,0 |
| BrowseComp-Plus | 4,5 | 1,9 | 2,8 | 0,2 | 0,8 |
| ToolSandbox | 64,6 | 30,5 | 41,2 | 45,7 | 28,1 |
| Promedio | 45,0 | 24,7 | 38,8 | 25,3 | 22,7 |
Criterios de evaluación en porcentaje (mayor es mejor): BFCL v4 pondera 40 % Agentic, 30 % Multi-Turn, 10 % Live, 10 % Non-Live y 10 % Hallucination (media de 3 ejecuciones); ACEBench mide precisión en function calling (2 ejecuciones); τ-bench promedia τ²-bench (retail y telecom) y τ³-bench (banking) excluyendo aerolíneas (3 ejecuciones); Claw-Eval calcula seguridad × (0,8 × compleción + 0,2 × robustez) en 3 ejecuciones; BrowseComp-Plus limita cada tarea a 30 pasos; y ToolSandbox promedia la similitud en 8 configuraciones.
Conocimiento general, seguimiento de instrucciones y límites multilingües
La especialización agéntica no penalizó el conocimiento general del modelo base, sino que lo situó por encima de todas las arquitecturas comparadas de hasta 1.200 millones de parámetros. No obstante, el conocimiento fáctico sigue escalando con el tamaño, por lo que Qwen3.5-2B-Think conserva una ventaja holgada en GPQA Diamond y MMLU-Pro; por diseño, BotPsy está pensado para consultar hechos mediante herramientas externas en vez de memorizarlos.
En seguimiento explícito de instrucciones, BotPsy-0.8B lidera tanto IFEval como IFBench. En la prueba multilingüe Multi-IF, que evalúa tres turnos seguidos en ocho idiomas, iguala en promedio a Qwen3.5-2B-Think y queda cerca de LFM2.5-1.2B-Think.
Por turnos dentro de Multi-IF, BotPsy abre en cabeza en el primer intercambio (84,3), pero desciende a 51,0 en el tercero a medida que se acumulan restricciones, por debajo de Qwen3.5-2B-Think (56,5) y LFM2.5-1.2B-Think (56,2). Por lenguas, rinde entre 72 y 80 puntos en español, inglés, chino, francés, italiano y portugués, pero cae en hindi (24,5) y ruso (57,6).
| Benchmark | BotPsy-0.8B | Qwen3.5-0.8B-Think (base · 1×) | Qwen3.5-2B-Think (2,5×) | LFM2.5-1.2B-Think (1,5×) | MiniCPM5-1B-Think (1,25×) |
|---|---|---|---|---|---|
| GPQA Diamond (198 preguntas, 3 ejecuciones) | 38,1 | 33,2 | 59,9 | 35,0 | 15,8 |
| MMLU-Pro (precisión) | 48,9 | 41,6 | 65,5 | 39,4 | 40,0 |
| IFEval (precisión estricta) | 90,8 | 59,7 | 80,0 | 85,6 | 78,4 |
| IFBench (precisión estricta) | 55,9 | 22,0 | 40,9 | 33,9 | 40,6 |
| Multi-IF (3 turnos, 8 idiomas) | 67,2 | 43,2 | 66,9 | 68,2 | 53,4 |
Interacción multiturno, abstención de llamadas y puntos débiles
Las mayores mejoras relativas se concentran en interacciones con estado (stateful) de múltiples turnos, donde BotPsy lidera cuatro de las cinco pruebas evaluadas. En BFCL v4 multiturno salta de 7,5 a 46,1 —casi el doble que Qwen3.5-2B-Think (23,8)—, y en ACEBench Agent sube de 7,9 a 28,3 frente a 16,2 del modelo mayor.
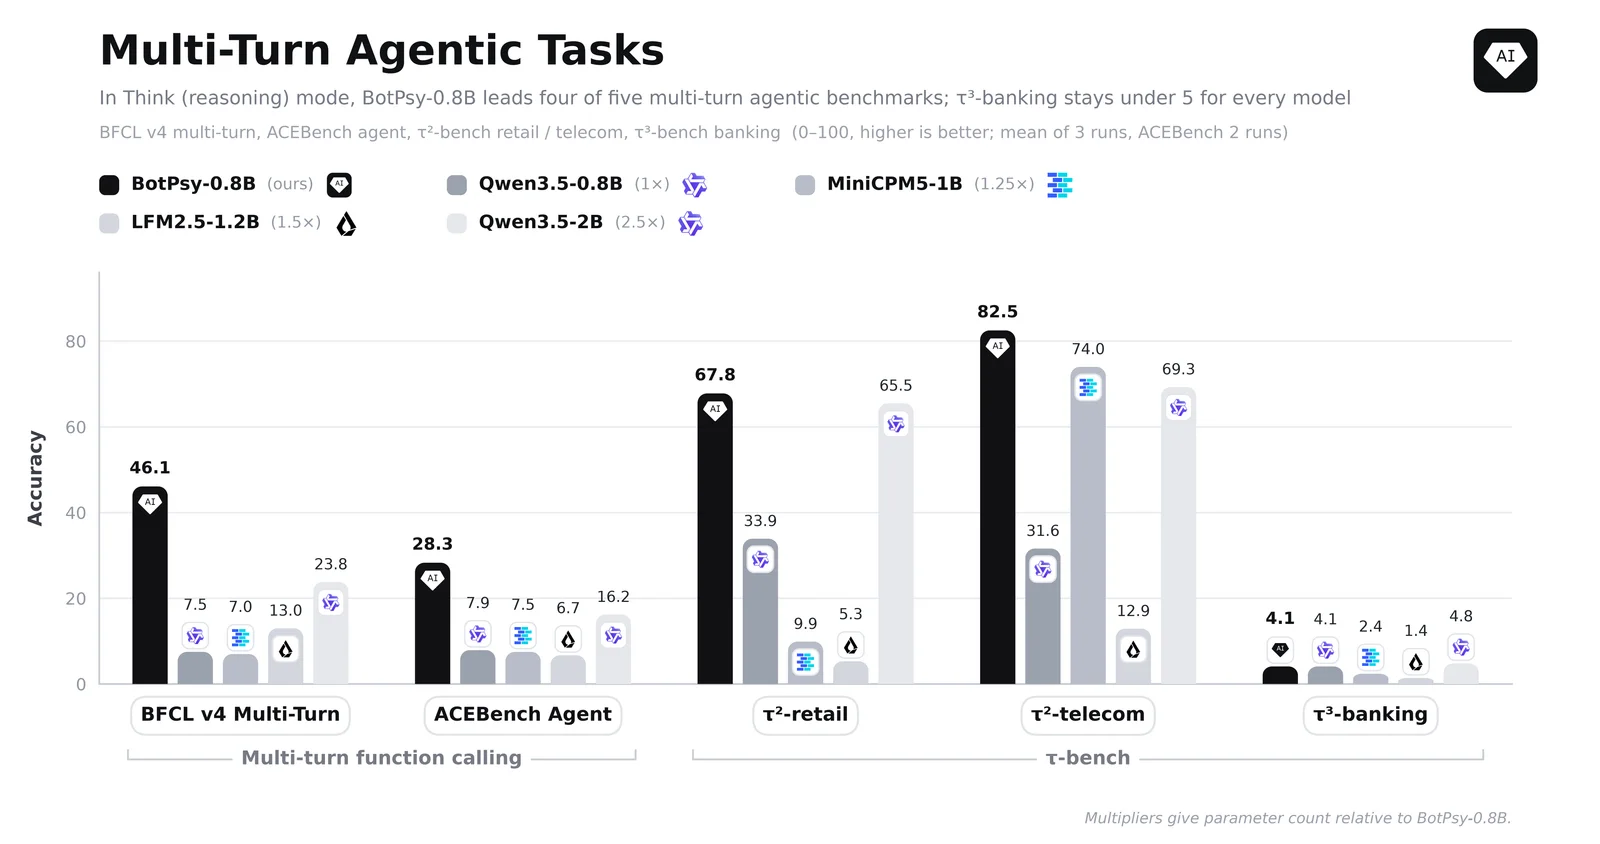
Rendimiento en benchmarks agénticos multiturno: BotPsy-0.8B lidera cuatro de los cinco conjuntos evaluados, mientras ningún modelo supera los 5 puntos en τ³-banking (Hugging Face / Tether AI Research).
En τ²-bench, el modelo duplica a su base en comercio minorista (67,8 frente a 33,9, superando el 65,5 de Qwen3.5-2B-Think) y alcanza 82,5 en telecomunicaciones, por delante de MiniCPM5-1B-Think (74,0) y Qwen3.5-2B-Think (69,3). Además, lidera la fiabilidad en llamadas únicas (BFCL non-live: 83,0) y en pruebas de alucinación (BFCL hallucination: 86,1), al negarse a invocar herramientas inexistentes.
Sus puntos débiles recaen en la búsqueda web abierta, la memoria y determinadas pruebas donde Qwen3.5-2B-Think mantiene ventaja. En BFCL, BotPsy obtiene 14,0 en búsqueda web y 16,3 en memoria, frente a 19,8 y 26,1 del modelo de 2.000 millones de parámetros.
Aunque en casos especiales de ACEBench —peticiones incompletas o con parámetros erróneos— progresa de 13,7 a 51,3, aún cede ante Qwen3.5-2B-Think (58,0). En τ³-banking, por su parte, ningún modelo rebasa los 5 puntos: BotPsy mantiene el 4,1 de su base y Qwen3.5-2B-Think alcanza 4,8.
Desempeño por tipo de aplicación: llamadas simples frente a flujos complejos
Al agrupar los escenarios por categoría de aplicación, BotPsy obtiene 75 puntos globales en tareas simples de un solo turno y una llamada, 21 puntos por encima de su base (54) y por delante de Qwen3.5-2B-Think (70). En todos los grupos con muestra representativa logra entre 70 y 79 puntos (el bloque de comunicación y redes sociales solo incluye 6 casos simples).
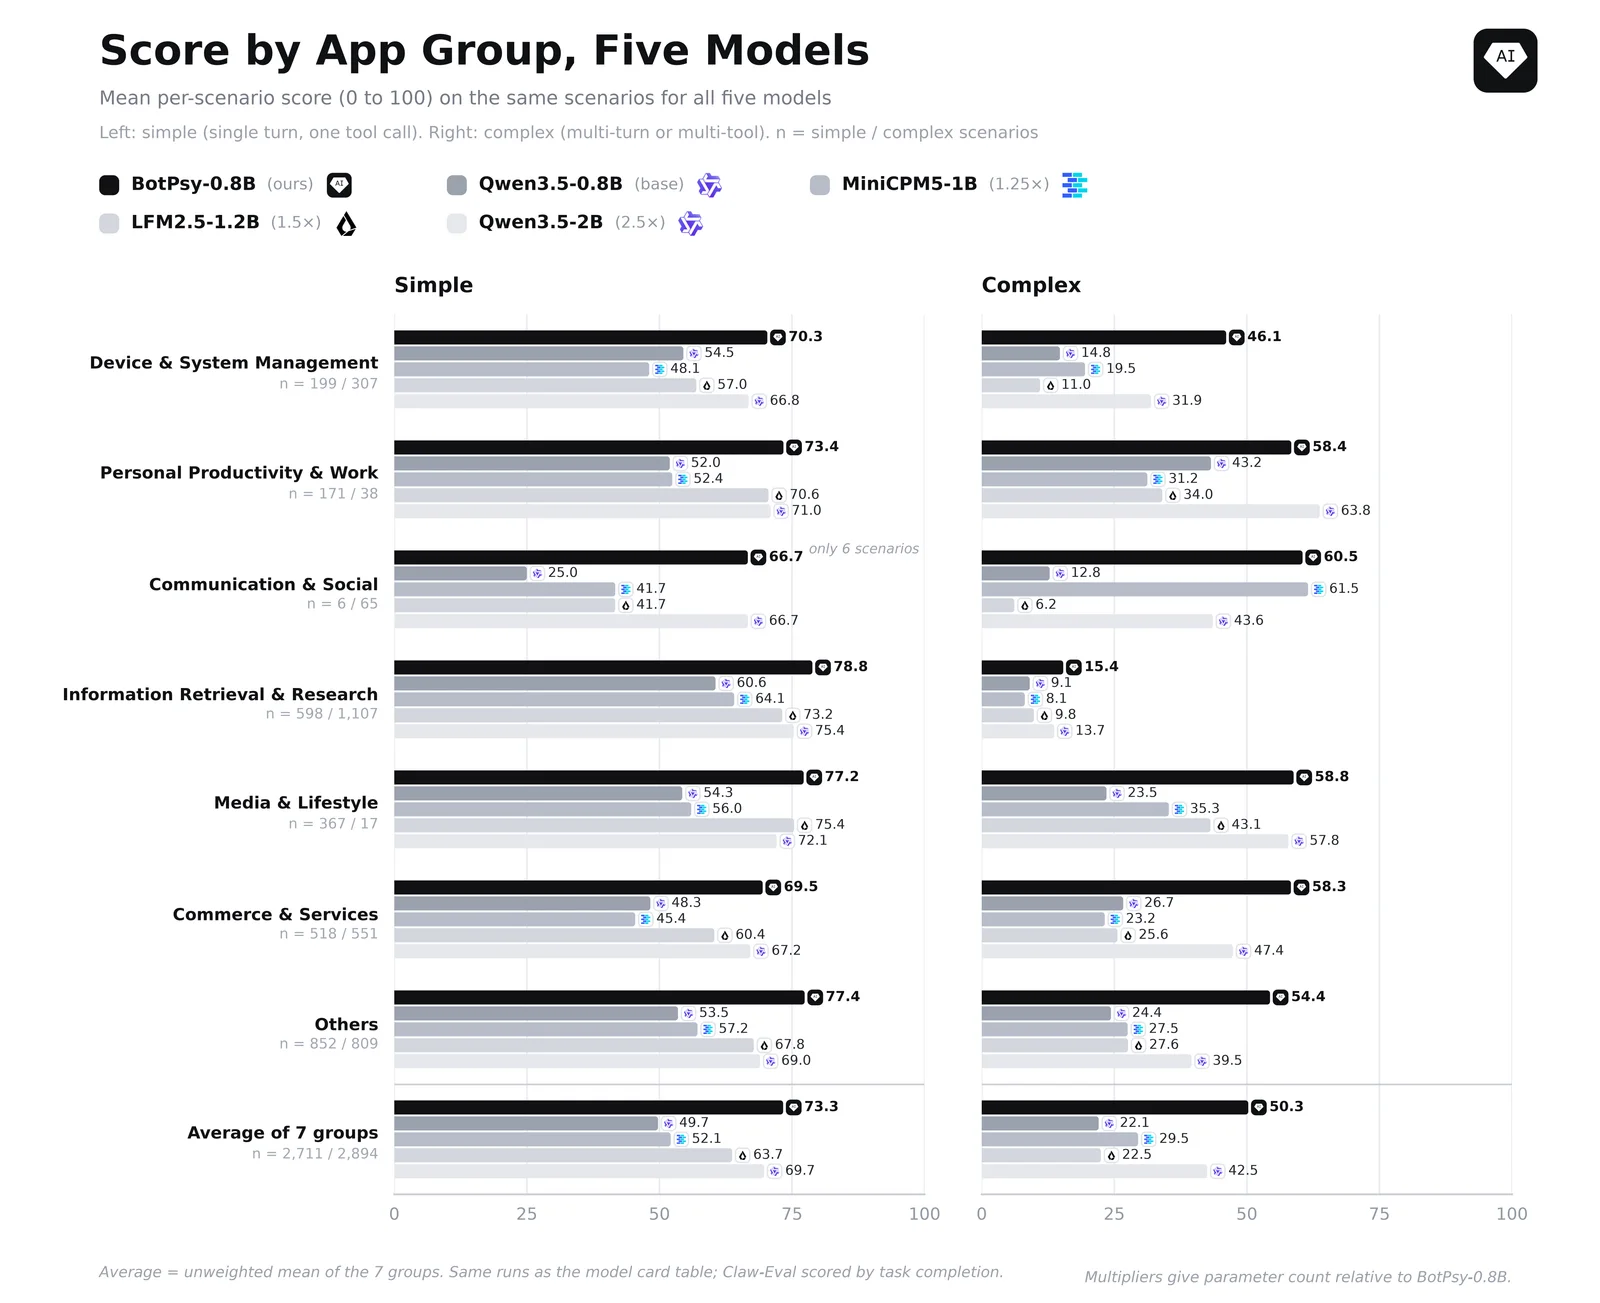
Desglose por grupo de aplicaciones en escenarios simples (izquierda) y complejos (derecha); la fila inferior muestra la media no ponderada de los siete grupos (Hugging Face / Tether AI Research).
En flujos complejos de varios pasos o múltiples herramientas, la media global de BotPsy sube a 39,5, frente a 17,9 del modelo base y 30,8 de Qwen3.5-2B-Think. En comercio y servicios lidera con 58,3 puntos (frente a 47,4 de Qwen3.5-2B-Think y 27 del base) y en gestión de dispositivos y sistemas escala de 15 a 46,1 (frente a 31,9).
El mayor salto relativo ocurre en comunicación y redes sociales, donde pasa de 13 a 60,5, aunque MiniCPM5-1B-Think conserva una ventaja mínima (61,5). Productividad personal y trabajo —con 38 escenarios dominados por Claw-Eval— es el único ámbito complejo donde Qwen3.5-2B-Think se impone (64 frente a 58).
No obstante, las tareas multipaso mantienen puntuaciones inferiores a las llamadas simples en toda la comparativa. La recuperación compleja de información e investigación constituye el mayor límite para este tamaño (15 puntos frente a 79 en llamadas simples), lastrada por consultas profundas de BrowseComp-Plus donde el base marca 9 y Qwen3.5-2B-Think obtiene 14.
Eficiencia de razonamiento, reducción de bucles y seguridad
Para aislar el coste de cómputo de la dificultad de las preguntas, las mediciones de eficiencia compararon únicamente los problemas resueltos por los cinco modelos, contando tokens con el tokenizador propio de cada uno. En las cuatro pruebas analizadas, BotPsy-0.8B utiliza entre 1,4× y 3,1× menos tokens de razonamiento por acierto que su modelo base y logra mayor precisión en todas ellas.
| Benchmark | Tokens de razonamiento (BotPsy-0.8B) | Tokens de razonamiento (Qwen3.5-0.8B-Think) |
|---|---|---|
| GPQA Diamond | 3.690 | 11.563 |
| MMLU-Pro | 1.912 | 5.105 |
| IFEval | 3.148 | 4.433 |
| IFBench | 4.204 | 11.576 |
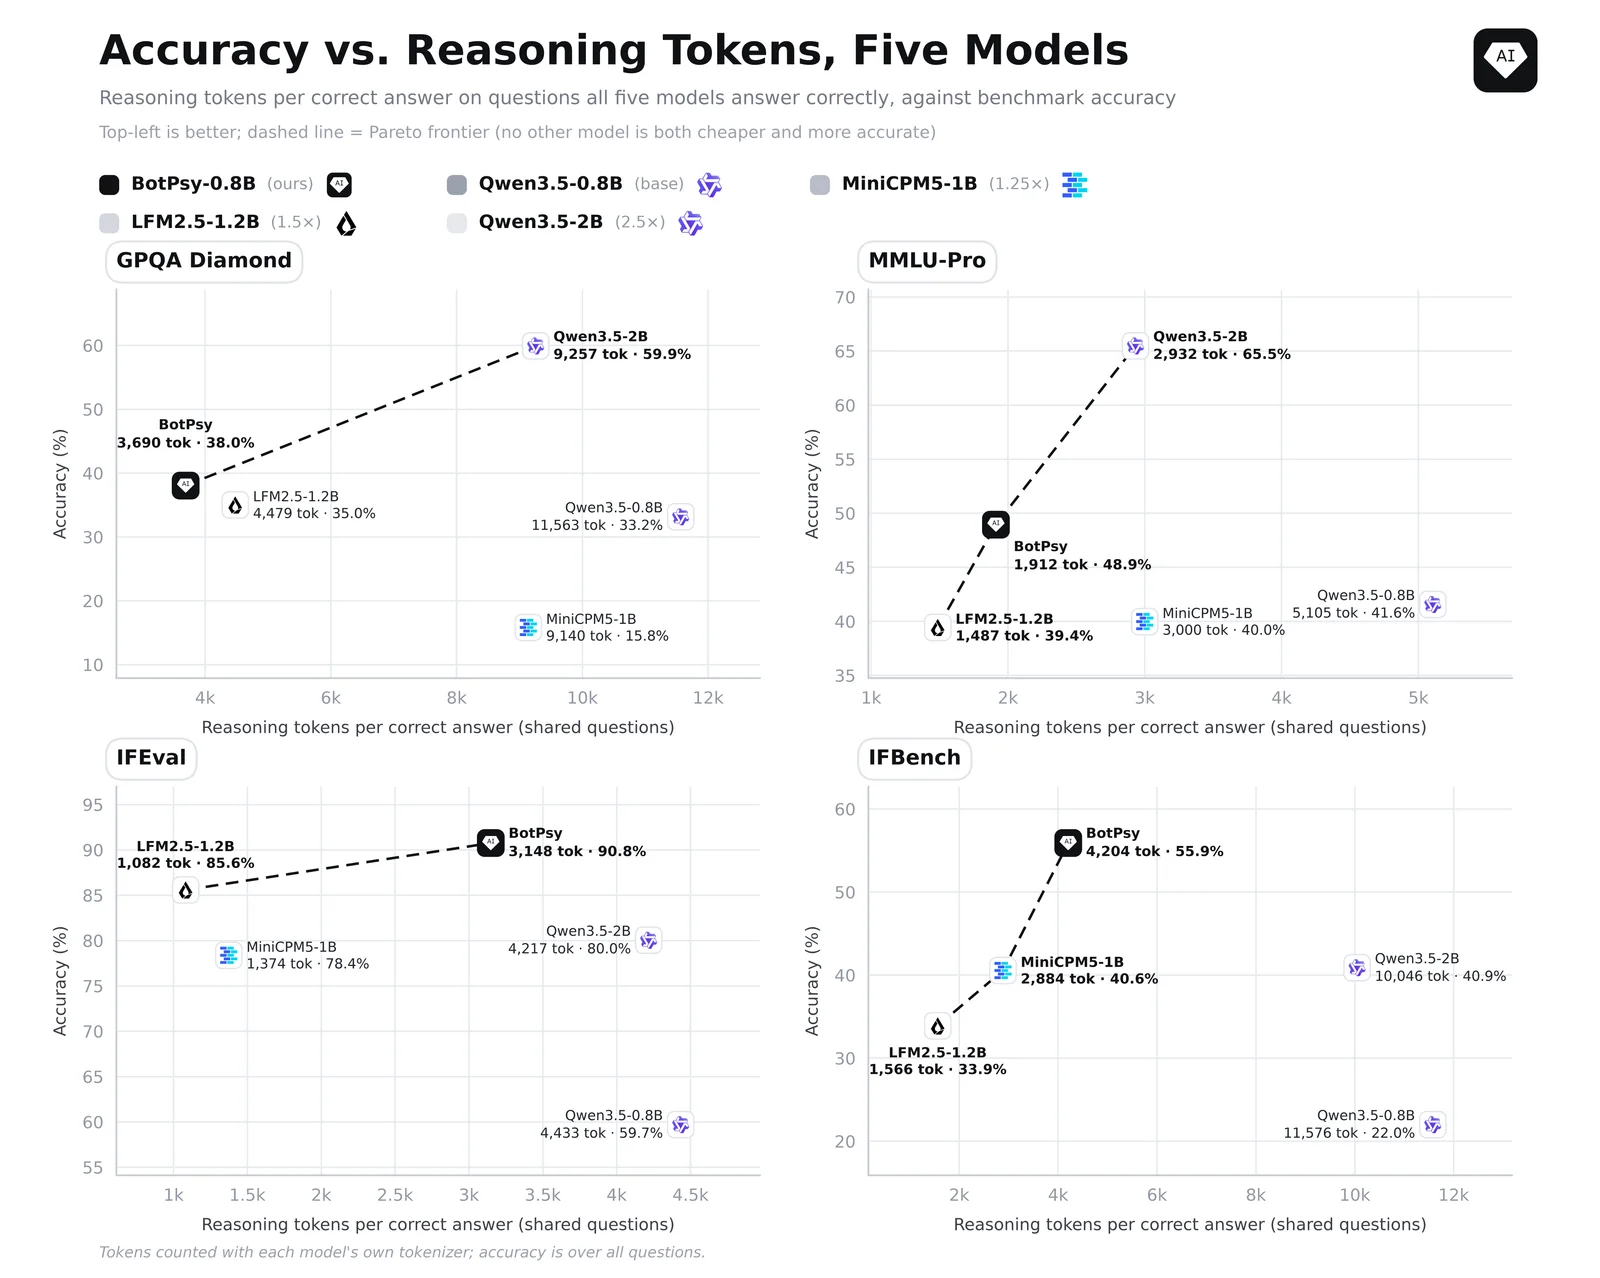
Precisión frente a tokens de razonamiento por respuesta correcta en GPQA Diamond, MMLU-Pro, IFEval e IFBench; la esquina superior izquierda marca la frontera de Pareto óptima (Hugging Face / Tether AI Research).
Aunque LFM2.5-1.2B-Think genera respuestas más breves en MMLU-Pro, IFEval e IFBench —y MiniCPM5-1B-Think en estas dos últimas—, ambos ofrecen menor precisión que BotPsy. A su vez, la proporción de bucles repetitivos en todos los intentos de IFBench cae del 22,9 % al 1,4 %, y las ejecuciones truncadas al llegar a 32.000 tokens descienden del 28,3 % al 0,2 %.
En tareas de τ²-bench resueltas por los cinco modelos, BotPsy necesita menos turnos que su base mientras multiplica la tasa de éxito (2,0× en comercio minorista y 2,6× en telecomunicaciones). Esta mayor concisión en las cadenas de pensamiento busca reducir la latencia cuando se ejecuta localmente en el dispositivo.
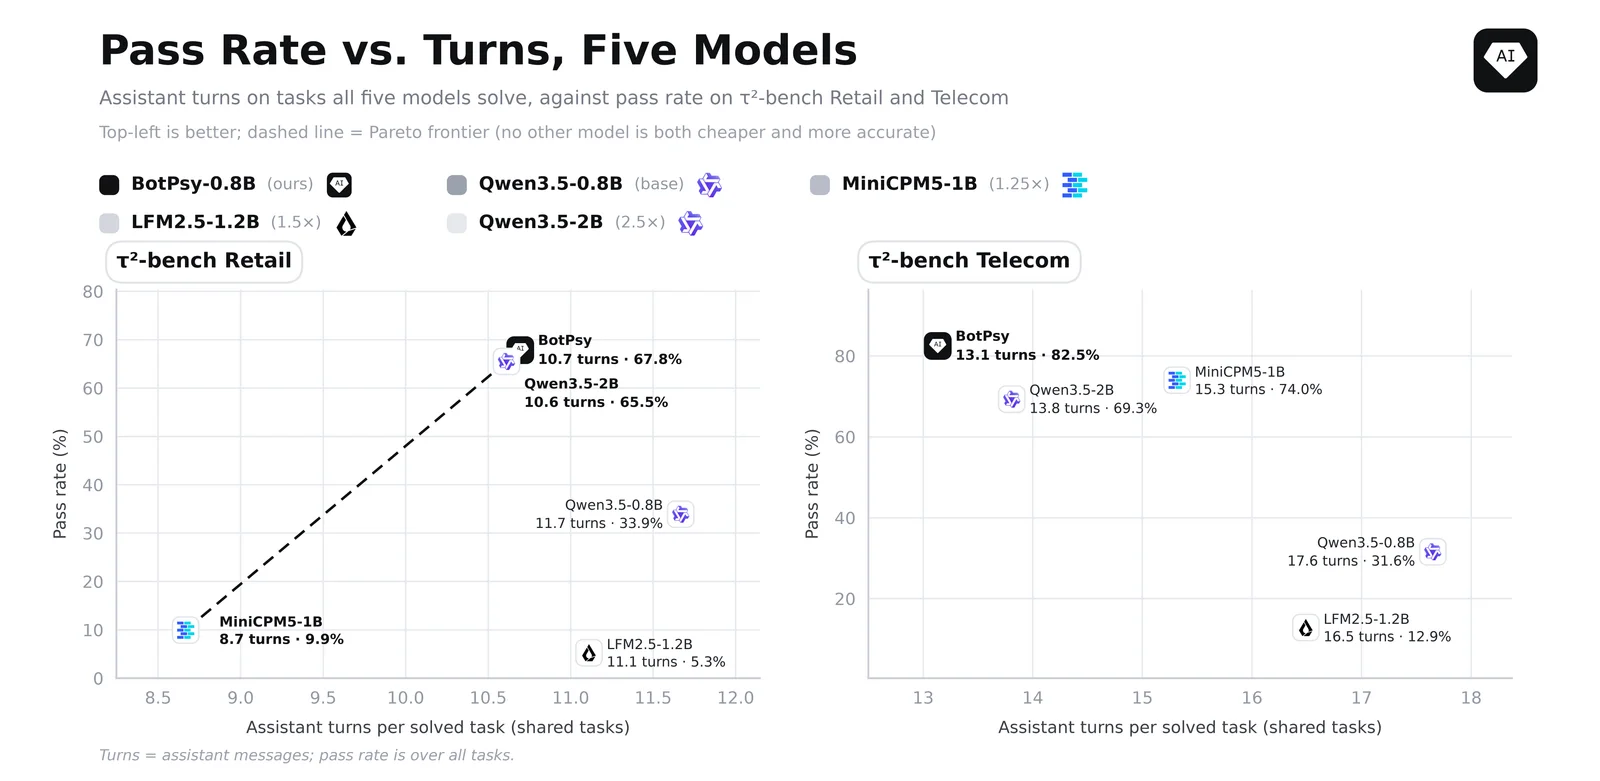
Tasa de éxito frente a turnos del asistente por tarea resuelta en τ²-bench de comercio minorista y telecomunicaciones (Hugging Face / Tether AI Research).
En comercio minorista promedia 10,7 turnos frente a 11,7 del base (9 % menos) y 10,6 de Qwen3.5-2B-Think (MiniCPM5-1B-Think baja a 8,7, pero solo resuelve el 9,9 % de las tareas). En telecomunicaciones requiere 13,1 turnos ante 17,6 del modelo base (26 % menos) y 13,8 de Qwen3.5-2B-Think (5 % menos).
En seguridad, las evaluaciones automatizadas de red-teaming en seis categorías de daño arrojan una tasa de respuestas inseguras del 21 % en BotPsy, la más baja entre los modelos de hasta 1.200 millones de parámetros (36 % en su base, 35 % en LFM2.5-1.2B-Think y 47 % en MiniCPM5-1B-Think). Bajo ataques de prompt injection —críticos al leer salidas no confiables de herramientas—, el porcentaje inseguro baja del 46 % al 31 %.
Casos de uso, limitaciones y hoja de ruta de Tether AI Research
Orientado a tareas de dificultad baja a media, BotPsy cubre seis dominios: gestión de dispositivos y sistemas (ajustes, archivos, relojes y alarmas), productividad y trabajo (calendario, correo y colaboración), comunicación, búsqueda e investigación (web, clima y noticias), medios y estilo de vida (vídeo, música, recetas, ejercicio y fotos) y comercio y servicios (mapas, viajes, finanzas y compras).
Al haberse entrenado y validado principalmente en inglés, este sigue siendo el idioma recomendado pese a los buenos resultados en español, francés, italiano, portugués y chino. Como modelo compacto sujeto a errores, Tether AI Research advierte que no está destinado a decisiones críticas para la seguridad, automatizaciones de alto riesgo ni aplicaciones sensibles relacionadas con dinero, salud o datos personales.
En futuras iteraciones, Tether Data, S.A. de C.V. planea expandir Tether Hypersearch con consultas cifradas peer-to-peer sin rastreadores corporativos y optimizar el ajuste fino local con QVAC Fabric. La hoja de ruta incluye también delegar cómputo pesado desde el smartphone hacia ordenadores domésticos o nodos confiables en transiciones offline-online y habilitar comunicación segura entre agentes en redes locales manteniendo credenciales y datos en hardware propio.
Fuente: BotPsy: On-Device Personal Assistant with a Sub-Billion-Parameter Agentic Language Model