Amazon HOPE poda hasta el 50 % de los expertos en modelos MoE mediante programación cuadrática
Amazon presenta HOPE, un algoritmo de poda de segundo orden que usa programación cuadrática para reducir modelos MoE conservando expertos cooperativos.
Los modelos de lenguaje basados en arquitecturas Mixture-of-Experts (MoE) permiten escalar redes neuronales hasta cientos de miles de millones de parámetros manteniendo un coste computacional acotado por token. Sin embargo, este diseño obliga a alojar todos los módulos expertos en memoria durante la inferencia, aunque la gran mayoría permanezca inactiva en cada paso.
Para resolver este cuello de botella sin reentrenar los modelos, un equipo de investigación de Amazon integrado por Alex M Tseng, Prannay Kaul, Luca Zancato, Wei Xia y Stefano Soatto presentó HOPE (Higher-Order Pruning of Experts), según detalla en Hugging Face. El método, publicado también en arXiv:2609.18916, elimina expertos de forma permanente mediante programación cuadrática binaria para preservar las parejas que cooperan entre sí.
El límite de la poda de primer orden en modelos MoE
La magnitud del problema de memoria resulta evidente en arquitecturas actuales como Qwen3.5-122B, que integra 256 expertos en cada una de sus 48 capas MoE. Aunque el router solo activa 8 expertos por capa para procesar cada token, las redes MLP de esos expertos consumen el 95 % de los cerca de 250 GB de memoria de parámetros del modelo.
Descartar de forma definitiva los expertos menos útiles evita la latencia asociada a cargar y descargar pesos dinámicamente, no exige reentrenamiento y puede combinarse con cuantización, una propiedad documentada en trabajos previos como REAP. Hasta ahora, los algoritmos convencionales de primer orden evaluaban cada experto mediante una puntuación escalar independiente sobre datos de calibración. Este enfoque recorta cada capa de manera aislada bajo el supuesto de que los expertos actúan por separado.
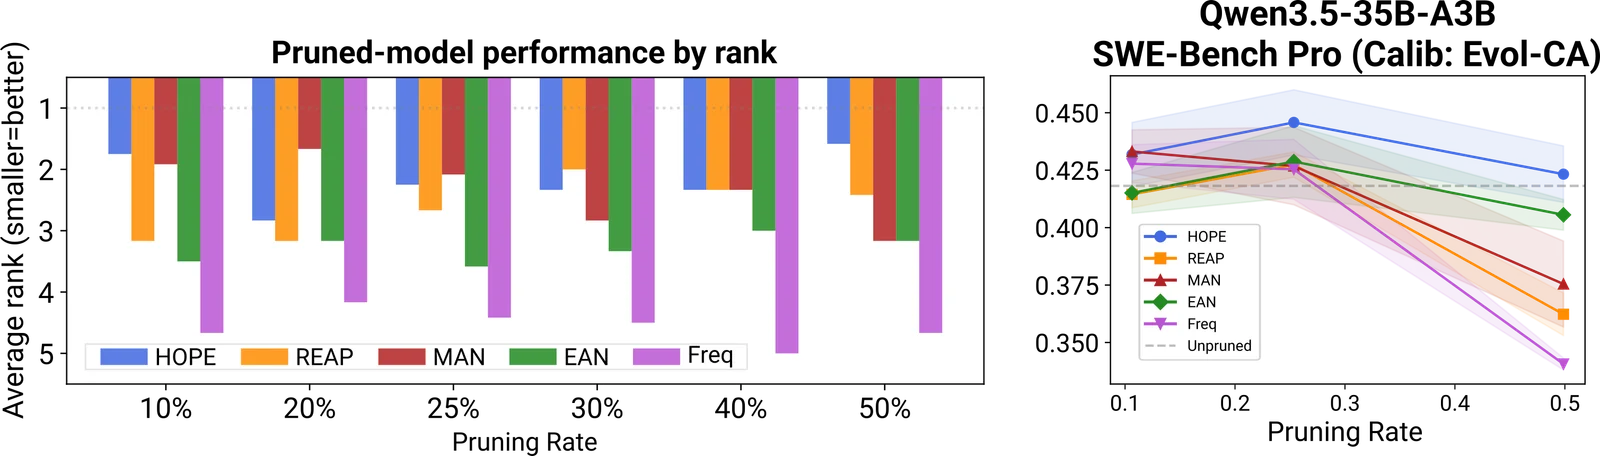
No obstante, investigaciones previas sobre dinámicas de enrutamiento (arXiv:2505.20225 y arXiv:2510.16411) demuestran que los expertos forman grupos cooperativos coactivados de forma estable. Ignorar estas dependencias degrada rápidamente la precisión cuando las tasas de recorte se vuelven agresivas. Al alcanzar un 50 % de poda, HOPE obtiene el mejor rango medio entre los métodos evaluados y logra mejoras de hasta +6,1 % en programación agéntica frente al segundo mejor enfoque.
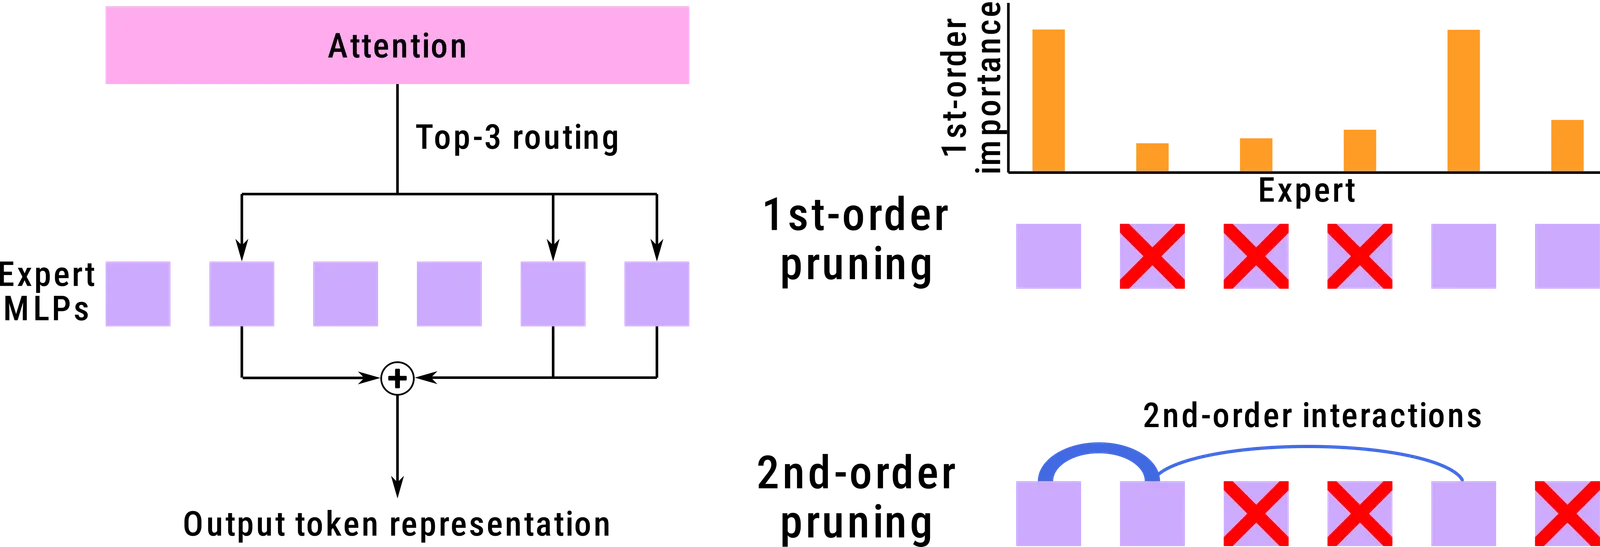
Cómo formula HOPE la poda mediante programación cuadrática
En una capa MoE estándar con E expertos, cada token x se dirige hacia un subconjunto activo T(x) de K expertos (habitualmente K = 8) ponderados mediante pesos softmax g(k, x). La salida de la capa equivale a la suma ponderada ∑ g(k, x) · f(k, x) sobre ese conjunto activo. Cuando se poda un subconjunto P, los expertos eliminados se reemplazan por los siguientes con mayor peso asignado por el router, generando un error de poda (pruning error).
Minimizar directamente ese error real resulta computacionalmente intratable porque los expertos sustitutos cambian según qué elementos integren P. Para sortear esta dificultad, los investigadores definen una cota superior tratable Z = [∑ g(j, x) · ‖f(j, x)‖₂]², sumada sobre los expertos j presentes tanto en P como en T(x), garantizando que Z sea siempre mayor o igual que el error real.
Al expandir el cuadrado de Z aparecen términos cruzados g(i, x) · g(j, x) · ‖f(i, x)‖₂ · ‖f(j, x)‖₂ entre pares de expertos. Minimizar el valor esperado de Z sobre los datos de calibración equivale a resolver el programa cuadrático binario (binary quadratic programming) pᵀ F p, sujeto a un vector binario p de longitud E con valores en {0, 1} cuya suma iguala al presupuesto de poda |P|. El equipo resuelve este problema mediante relajación continua y redondeo a una solución binaria.
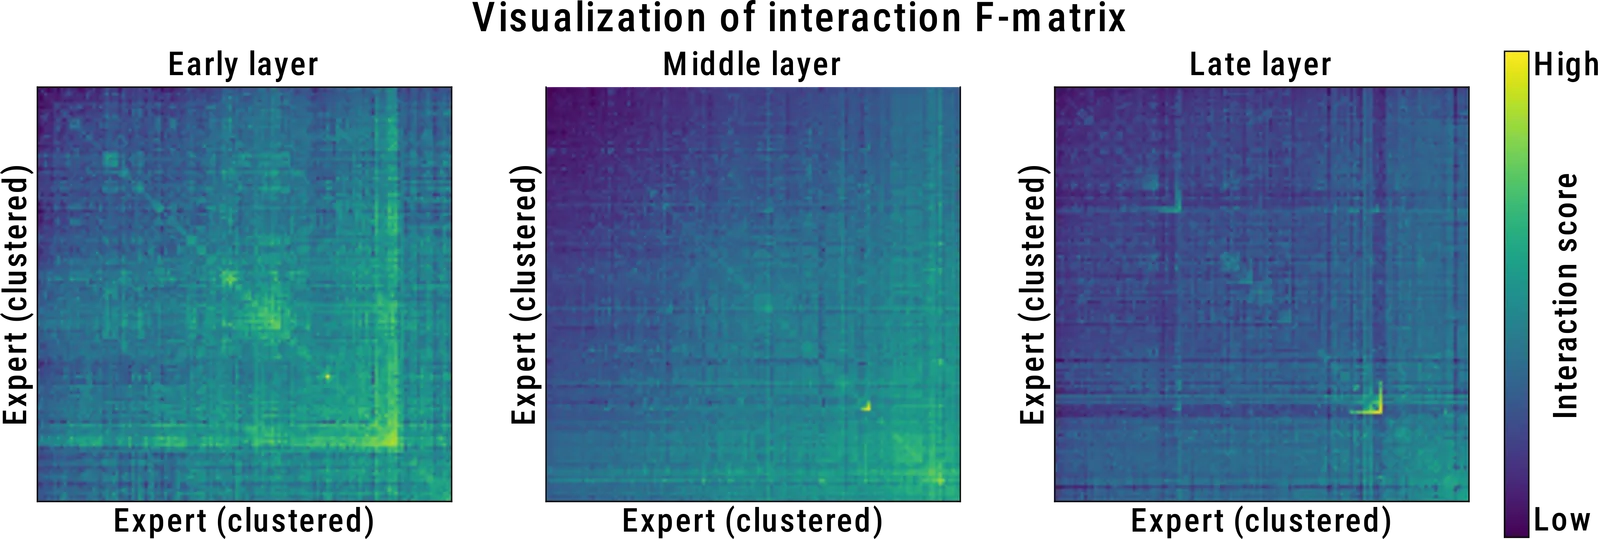
Cada entrada F(i, j) promedia ese producto cruzado sobre el subconjunto de tokens donde ambos expertos i y j están activos simultáneamente. De este modo, la diagonal F(k, k) mide la importancia individual, mientras que los elementos fuera de la diagonal (i ≠ j) cuantifican la cooperación por pares. En la práctica, HOPE aprovecha el mismo único forward pass de calibración que otros algoritmos y añade solo de 1 a 2 segundos por capa en un solver QP estándar.
Por qué HOPE discrepa de REAP y preserva clústeres
Al contrastar la matriz F con algoritmos previos, los autores comprueban que la diagonal de F reproduce de forma casi idéntica la clasificación de expertos de REAP, con una correlación de Spearman ρ = 0,988. Las ligeras diferencias en la diagonal obedecen únicamente a la varianza de las contribuciones individuales. La ventaja real de HOPE surge de los términos cooperativos fuera de la diagonal.
Allí donde HOPE y REAP toman decisiones distintas, los expertos retenidos exclusivamente por HOPE registran puntuaciones cooperativas medias más altas en F. En consecuencia, el algoritmo sacrifica ciertos expertos fuertes de forma aislada cuando hacerlo permite conservar clústeres cooperativos completos.
Evaluación experimental frente a cuatro métodos de primer orden
Para validar el algoritmo, el equipo evaluó tres modelos: Qwen3.5-122B, Qwen3.5-35B y GLM-4.5-Air, este último dotado de 128 expertos por capa y 106.000 millones de parámetros totales. La calibración se ejecutó con dos conjuntos de datos, Evol-CodeAlpaca y trayectorias de SWE-Bench Verified, midiendo el rendimiento en la suite Tulu3 y en agentic coding sobre SWE-Bench Pro. Se comparó HOPE con tasas de poda del 10 % al 50 % frente a cuatro baselines de primer orden: REAP, MAN, EAN y Frequency.
En las pruebas sobre Qwen3.5-35B-A3B al 50 % de poda en programación agéntica, la versión recortada con HOPE logra igualar e incluso superar ligeramente al modelo original sin podar. Según explican los autores, eliminar expertos poco relevantes puede reducir el ruido en tareas objetivo, como ya apuntaba arXiv:2504.06792. Además, la calibración enfocada en código no provocó una degradación severa en los benchmarks generales de Tulu3.
| Método o referencia | Orden de poda | Rango medio global (5 métodos) | Rango medio al 50 % de poda | SWE-Bench Pro en Qwen3.5-35B-A3B (50 % poda) |
|---|---|---|---|---|
| Modelo original sin podar | No aplica | — | — | 41,8 |
| HOPE (Amazon) | Segundo orden (pares) | 2,07 (top-1 en 39 %; top-2 en 67 %) | 1,58 | 42,3 |
| REAP | Primer orden (aislado) | Incluido en comparativa | 2,42 | 36,2 (regresión del 13 %) |
| MAN, EAN y Frequency | Primer orden (aislado) | Incluidos en comparativa | No desglosado | No desglosado |
Implementación open source compatible con vLLM y SGLang
El equipo de Amazon liberó el código en modo open source dentro del repositorio oficial awslabs/HOPE, junto con herramientas complementarias en awslabs/hybrid-model-factory. La implementación ha sido probada en las familias Qwen3, Qwen3-Next, Qwen3.5 y GLM-4.5. Como salida genera un checkpoint estándar de Hugging Face compatible directamente con motores de inferencia como vLLM y SGLang sin necesidad de cambios en su código.
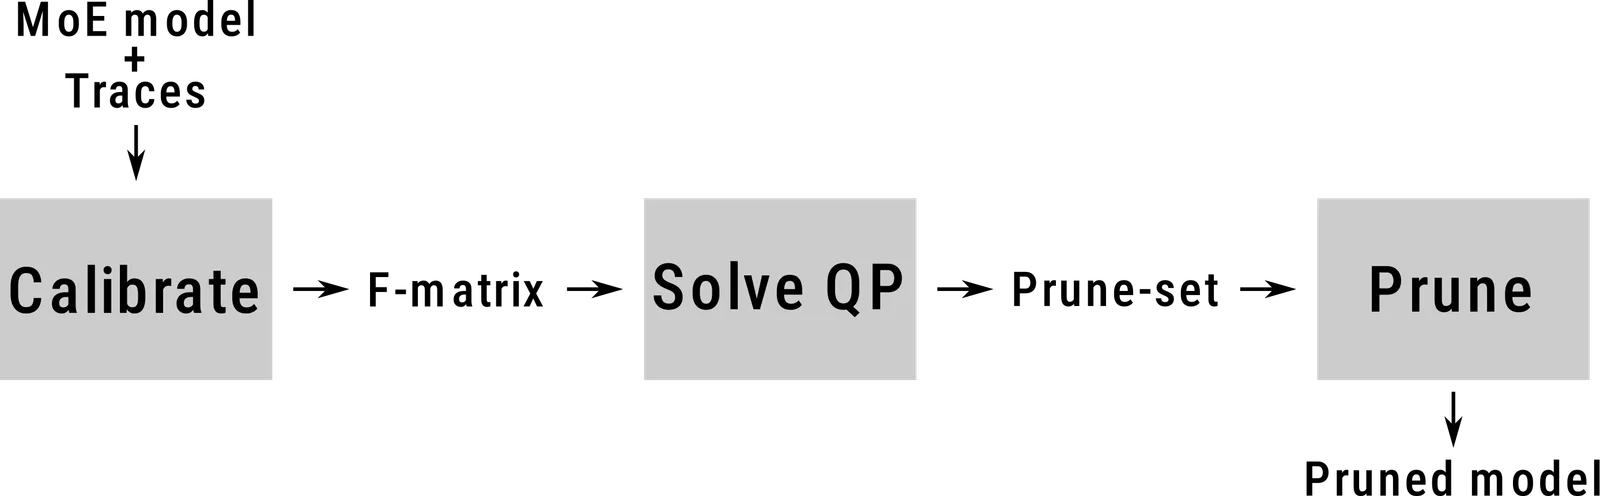
El flujo de trabajo se organiza a través de una CLI y una API en Python divididas en tres etapas secuenciales:
hope calibrate: ejecuta la fase de calibración sobre los datos de entrada para estimar la matriz de interacción F.hope solve --prune-frac 0.50: resuelve el programa cuadrático binario para la fracción de poda indicada (por ejemplo, un 50 %).hope prune: aplica la selección resultante y exporta el checkpoint podado compatible con Hugging Face.
Alcance actual y limitaciones del algoritmo
Los propios investigadores documentan tres límites técnicos que acotan el alcance actual de HOPE. En primer lugar, su ventaja destaca especialmente en podas agresivas de entre el 40 % y el 50 %, mientras que en recortes ligeros del 10 % al 20 % métodos de primer orden como REAP y MAN siguen siendo competitivos.
Por otro lado, el algoritmo recorta cada capa de manera independiente sin modelar interacciones entre capas distintas, pues el marco teórico cross-layer incluido en el estudio continúa en fase preliminar. Asimismo, la formulación cuadrática captura interacciones por pares y deja fuera sinergias de orden superior entre tríos o grupos más amplios por su complejidad combinatoria.
Fuente: Your Experts Have Partners. There’s HOPE for Keeping Them Together