Gradium Phonon TTS alcanza 28 ms de latencia inicial en CPU para síntesis de voz on-device desde 65 MB
Gradium detalla Phonon TTS: modelos de voz on-device desde 65 MB con 28 ms de latencia inicial en CPU, motor ptts e integración en Transformers v5.21.
La mayoría de los sistemas de voz basados en inteligencia artificial dependen de servidores remotos, lo que obliga a enviar cada frase a la nube antes de escuchar una respuesta. Con Phonon TTS, la compañía Gradium traslada la síntesis de voz directamente al dispositivo del usuario para operar sin conexión ni latencia de red, manteniendo el texto introducido en local.
Tras anunciar el proyecto en abril y abrir sus pesos dos semanas antes de publicar este balance técnico junto a Hugging Face, el modelo superó las 200.000 descargas. Firmado por Olesia Krizhevich, Laurent Mazare, Eric Bezzam y Eustache Le Bihan, el informe detalla cómo esta arquitectura combina baja latencia en CPU con soporte nativo en transformers.
Arquitectura ligera, idiomas y licenciamiento de Phonon TTS
Históricamente, ejecutar síntesis text-to-speech en hardware restringido exigía sacrificar fidelidad acústica para reducir el tamaño del modelo, o asumir requisitos de memoria incompatibles con equipos pequeños. Durante seis meses de trabajo con socios y primeros usuarios, Gradium redujo el peso de las redes y amplió el soporte multilingüe hasta lanzar su primera serie con open weights.
En el plano arquitectónico, Phonon parte del linaje de Pocket TTS y emplea flow matching para generar el audio, un enfoque distinto al de otras arquitecturas convencionales del sector. Esta técnica permitió alcanzar alta calidad con pocos millones de parámetros, aunque su entrenamiento resultó numéricamente inestable al inicio y requirió ajustes específicos para estabilizar los cinco idiomas soportados.
La familia ofrece más de 100 voces integradas y permite crear perfiles personalizados desde Gradium Studio, además de normalizar correctamente números de teléfono, fechas y códigos donde otros sintetizadores suelen fallar. Las dos variantes disponibles se distinguen tanto por su cobertura lingüística como por su modelo de licencia:
| Variante | Tamaño aproximado | Idiomas cubiertos | Licencia | Uso comercial |
|---|---|---|---|---|
| Phonon 31m | ~65 MB | Inglés | Apache 2.0 | Gratuito sin restricciones |
| Phonon 40m | ~75 MB | Inglés, francés, alemán, español y portugués | CC BY-NC | Tarifa basada en número de usuarios, no en volumen de voz |
Gracias a esa huella compacta, los modelos corren en teléfonos móviles, portátiles, computadoras de placa única y pestañas de navegador, con una demostración interactiva alojada en gradium/phonon. En entornos comerciales basados en Phonon 40m, la compañía optó por vincular el coste al volumen de usuarios finales en lugar de cobrar por la cantidad de voz generada.
Demostraciones sin conexión e integración temprana del ecosistema
El despliegue inicial recogido en el anuncio de lanzamiento de Gradium vino acompañado de prototipos diseñados para operar por completo fuera de línea. Entre ellos figuran un Apple Watch sin Wi-Fi que guía paso a paso la preparación de café y un iPhone sin cobertura móvil que cuenta repeticiones de entrenamiento en tiempo real.
Otros ejemplos mostraron al robot Lamp de Autonomous dialogando caracterizado con un sombrero parlante, una versión sin conexión del juego del dinosaurio en navegador convertida en programa de radio presentado por Rex, un videojuego de ciencia ficción con voces generadas en la máquina del jugador y lecturas completas de páginas de Proust.
En el frente de desarrollo, Hugging Face incorporó compatibilidad desde el primer día en transformers, mientras la comunidad publicó adaptaciones clave. Destacan una conversión en ExecuTorch para WebGPU que ejecuta inferencia en la GPU del navegador del visitante, el conector de Micdrop para aplicaciones Node.js y espacios experimentales como smallest-s2s.
Resultados en el Open TTS Leaderboard de Hugging Face
Para medir su rendimiento frente a más de 9.000 sistemas publicados en el Hub, la familia fue evaluada en el Open TTS Leaderboard, una plataforma que compara modelos abiertos en 23 idiomas. El benchmark evalúa inteligibilidad mediante word error rate, velocidad mediante inverse real-time factor y time-to-first-audio, y naturalidad con UTMOS en inglés y KOMOS en coreano.
La clasificación contempla tanto voces fijas como voice cloning —añadiendo una métrica de similitud del hablante en ese segundo modo— e incluye una pestaña Listen para comparar muestras lado a lado y votar. En inteligibilidad, Phonon obtuvo el primer puesto en alemán y español, manteniéndose entre los tres primeros en todos los idiomas evaluados junto a modelos hasta 100 veces más grandes.
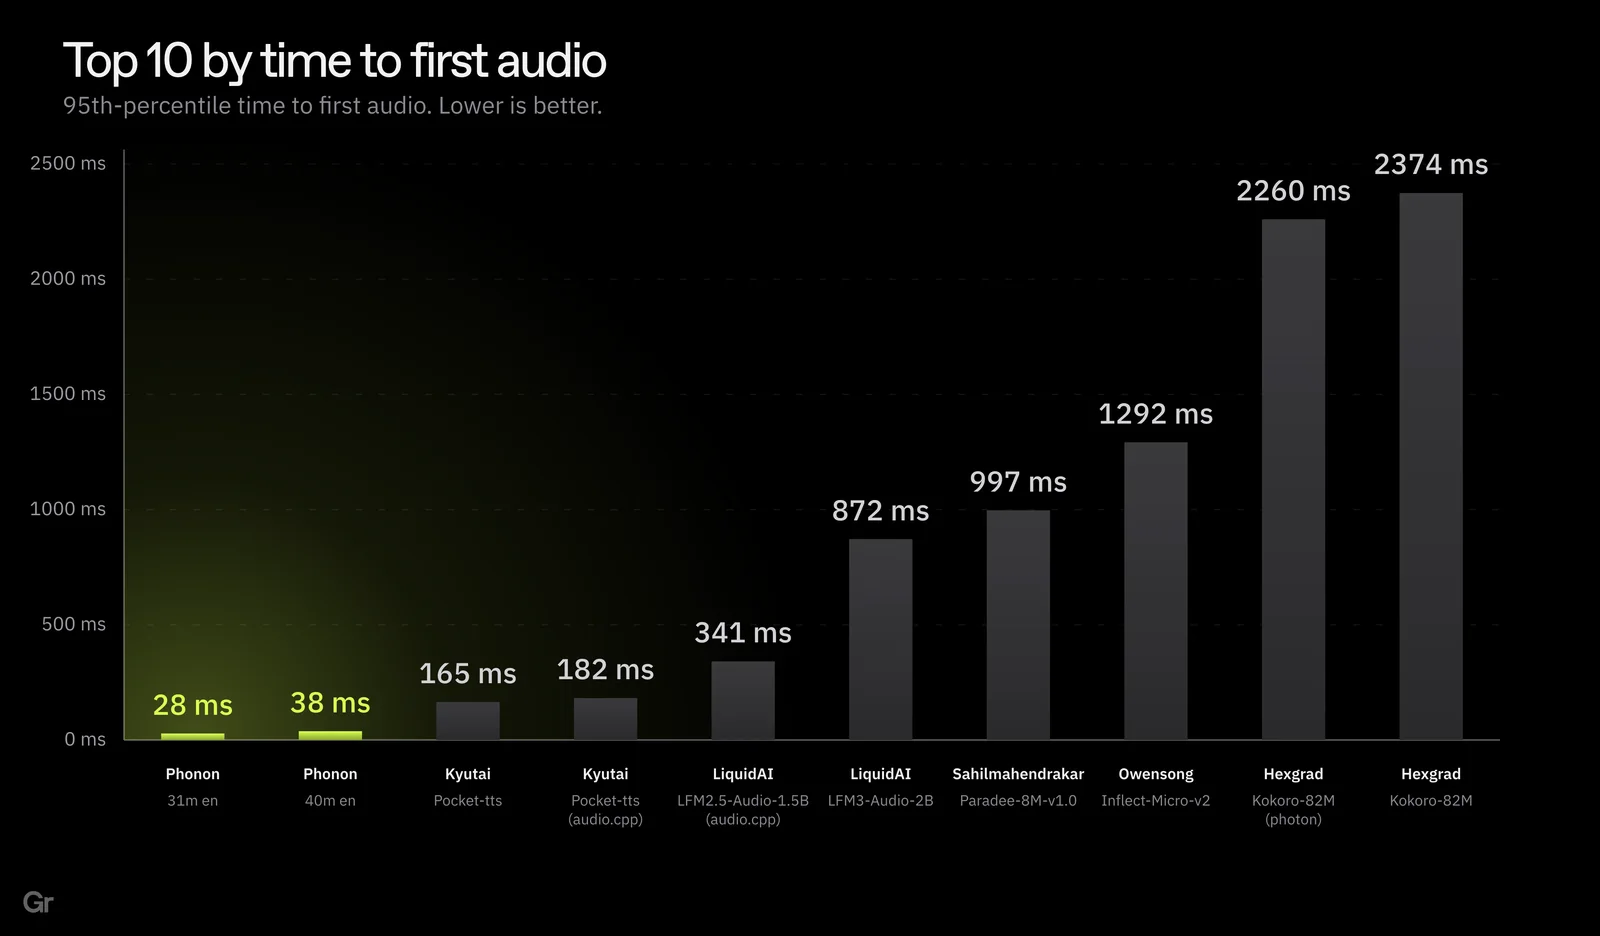
Donde la arquitectura marcó la mayor diferencia fue en el benchmark de streaming sobre CPU, encabezado por ambas variantes en tiempo hasta el primer audio dentro del percentil 95:
| Modelo evaluado | Tiempo hasta el primer audio en CPU (p95) | Posición en el benchmark |
|---|---|---|
| Phonon 31m en | 28 ms | 1.º puesto general |
| Phonon 40m en | 38 ms | 2.º puesto general |
| Pocket TTS | 165 ms | Referencia de la arquitectura base |
Inferencia local con ptts y generación por lotes en Transformers
Para exprimir el hardware local de consumo en un único flujo continuo (single-stream), Gradium desarrolló el motor específico ptts. Este framework de inferencia abarca más de diez backends distribuidos entre procesadores convencionales, aceleradores gráficos y unidades neuronales dedicadas:
| Tipo de acelerador | Backends compatibles en ptts |
|---|---|
| CPU | Intel, Arm, WebAssembly |
| GPU | CUDA, Vulkan, Metal, WebGPU |
| NPU | Apple Core ML, Snapdragon |
En paralelo, a partir de la versión v5.21, la biblioteca transformers ofrece la implementación oficial de referencia en PyTorch documentada en la ficha técnica de gradium_phonon_tts. Mientras ptts prioriza la mínima latencia en un dispositivo individual, la ruta de transformers apunta al throughput en GPU mediante inferencia por lotes y compilación completa con torch.compile para generar conjuntos de datos de voz a escala.
Como deriva de Pocket TTS, el modelo se integró siguiendo el esquema modular de la biblioteca en unas 200 líneas dentro de modular_gradium_phonon_tts.py, describiendo únicamente las diferencias específicas. Internamente genera audio latents de forma autorregresiva: cada paso produce un vector latente que retroalimenta el paso siguiente y sobre el cual se calcula la pérdida durante el entrenamiento.
En esta arquitectura, los latentes desempeñan el papel que los tokens de texto cumplen en un modelo de lenguaje, por lo que el códec actúa como un tokenizador de audio integrado en el procesador junto al de texto. En el checkpoint gradium/phonon-31m-en, la clase GradiumPhononTTSForConditionalGeneration suma 30.788.354 parámetros y processor.audio_tokenizer añade 10.305.313 parámetros.
Las voces tampoco se cargan como grabaciones sin procesar, sino como tensores precalculados de speaker latents con dimensión (num_frames, 512) alojados en gradium/phonon-voices. Dado que el tokenizador de audio se distribuye en modo decoder-only, Phonon nunca codifica audio directamente al inferir y recibe el estilo vocal mediante un chat template con un bloque audio vacío seguido del texto.
from huggingface_hub import hf_hub_download
from safetensors.torch import load_file
from transformers import AutoProcessor, GradiumPhononTTSForConditionalGeneration

model_id = "gradium/phonon-31m-en"
processor = AutoProcessor.from_pretrained(model_id, device_map="auto")
model = GradiumPhononTTSForConditionalGeneration.from_pretrained(model_id, device_map="auto")

path = hf_hub_download("gradium/phonon-voices", "voices/LMDIYE0Oa377Qh6Z.safetensors")
voice = load_file(path)["speaker_wavs"][0].T  # (num_frames, 512)

conversation = [
    {"role": "user", "content": [{"type": "audio"}, {"type": "text", "text": "Hello from Phonon."}]}
]
inputs = processor.apply_chat_template(
    conversation,
    tokenize=True,
    return_dict=True,
    add_generation_prompt=True,
    processor_kwargs={"audio_prompt_latents": [voice]},
).to(model.device)

outputs = model.generate(**inputs)  # audio_latents: (batch_size, num_frames, 32)
audio = processor.decode(outputs.audio_latents, outputs.audio_latents_mask)
processor.save_audio(audio, "phonon.wav")
Al invocar processor.apply_chat_template, el procesador expande el marcador de voz a una posición <|audio_prompt|> por cada fotograma latente, normaliza y tokeniza el texto y añade el símbolo de inicio <|audio_bos|>. Posteriormente, model.generate devuelve los audio_latents con formato (batch_size, num_frames, 32), que processor.decode y processor.save_audio transforman en la forma de onda final en phonon.wav.
Clonación de voces y modelos a medida para socios
Para personalizar identidades sonoras, el flujo de trabajo permite clonar una voz a partir de una grabación breve —siempre con consentimiento del hablante— o diseñarla mediante una descripción en texto plano dentro de Gradium Studio. El archivo resultante se descarga y se carga en local para sintetizar voz completamente on-device.
Además de los checkpoints públicos, Gradium entrena variantes personalizadas de Phonon junto a socios de diseño cuando un proyecto exige ajustar aún más el presupuesto de memoria o adaptar el vocabulario específico de un producto. Entre los idiomas adicionales disponibles bajo entrenamiento a medida figuran el coreano, el árabe y el japonés.
Fuente: A Closer Look at Phonon TTS. Launching High-Quality On-Device Speech That Tops the Benchmarks.