Decision Models en Hugging Face unifica Choice, Score y Noul para tomar decisiones probabilísticas sin generar texto
Hugging Face estandariza los decision models con Choice, Score y Noul en transformers y llama.cpp para obtener probabilidades sin generar texto.
Los modelos de lenguaje grandes (LLMs) destacan al redactar texto, programar o razonar, pero muchas tareas de software no requieren generación abierta. Cuando un sistema de soporte recibe un mensaje de cobro duplicado con solicitud de reembolso, necesita enrutar el caso, medir su urgencia y confirmar la petición sin producir prosa innecesaria.
Para cubrir ese hueco con una interfaz unificada, el equipo técnico integrado por Aritra Roy Gosthipaty, Lysandre, Pedro Cuenca y Tom Aarsen presentó en Hugging Face el estándar de decision models dentro de su ecosistema open source. Estos modelos evalúan un contexto de entrada y devuelven distribuciones de probabilidad estructuradas sobre respuestas predefinidas sin generar ningún token de salida.
Qué son los decision models y por qué sustituyen al JSON generativo
La práctica habitual para clasificar o enrutar incidencias consiste en pedir a un LLM —como ggml-org/gemma-4-e4b-it-GGUF:Q4_0 mediante llama cli— que razone y devuelva un objeto JSON con el departamento, la urgencia y el tipo de solicitud. Aunque funciona en prototipos, depender de la generación autorregresiva introduce tres fricciones operativas relevantes.
En primer lugar, incluso con instrucciones explícitas, un modelo generativo puede emitir JSON inválido, inventar claves o responder fuera del conjunto permitido. En segundo lugar, bibliotecas de constrained decoding como Outlines y XGrammar restringen los tokens válidos en cada paso para garantizar la estructura, pero añaden sobrecarga computacional.
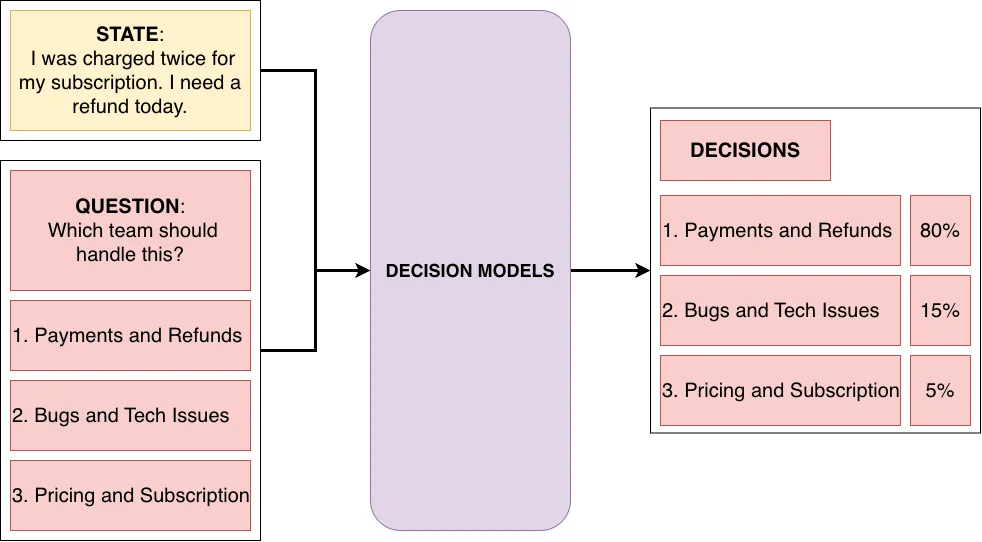
En tercer lugar, generar una respuesta completa token a token resulta redundante cuando la aplicación solo necesita elegir entre opciones ya conocidas. La propuesta de decision models resume su contrato operativo en una fórmula directa: State + Questions + Allowed Answers → Decisions + Probabilities.
En cuanto a la terminología, TypeSafe AI había presentado previamente Jev como un System One model, en alusión al contraste cognitivo entre el pensamiento rápido e intuitivo (System 1) y el deliberativo (System 2). Tras una encuesta abierta impulsada por Gosthipaty, la comunidad adoptó el nombre decision model por describir mejor su función computacional, aunque la ruta de servidor conserva /v1/systemone.
Diferencias frente a la clasificación tradicional y zero-shot
Antes de detallar el contrato técnico, conviene distinguir esta arquitectura de dos enfoques previos muy extendidos. Un clasificador convencional aprende durante el entrenamiento un mapeo fijo hacia etiquetas cerradas —como facturación, soporte técnico o ventas— cuya cabeza de salida genera un logit por clase y lo normaliza con softmax.
Esa rigidez impide añadir nuevas categorías en producción: incorporar un departamento legal obliga a modificar la cabeza de clasificación, reunir ejemplos y reentrenar el modelo. La clasificación zero-shot supera parte de ese límite al recibir las etiquetas candidatas en inferencia, como ocurre al ejecutar facebook/bart-large-mnli mediante inferencia de lenguaje natural (NLI).
En las pruebas sobre facebook/bart-large-mnli, agregar la etiqueta legal junto a facturación, ventas y soporte técnico recalcula al instante las puntuaciones (0,8186 para facturación frente a 0,0332 para legal, desde el 0,8467 previo con tres clases). Sin embargo, los decision models amplían ese enfoque al aceptar varias preguntas tipadas sobre un mismo estado en una sola interfaz probabilística:
| Propiedad | Clasificación tradicional | Clasificación zero-shot | Decision model |
|---|---|---|---|
| Probabilidad sobre opciones | Sí | Sí | Sí |
| Etiquetas definidas en inferencia | No | Sí | Sí |
| Múltiples preguntas tipadas | No | No | Sí |
| Puntuación ordenada y decisiones sí/no | Específica por tarea | Posible con adaptación | Primitivas nativas |
La interfaz de estado, preguntas y primitivas Choice, Score y Noul
Toda petición a un decision model se compone de dos bloques: state y questions. El campo state reúne el contexto que debe evaluarse, ya sea una cadena de texto plano, un objeto JSON estructurado —por ejemplo con customer_message, plan subscription y contador previous_tickets— u otras modalidades en modelos omnimodales compatibles.
Por su parte, questions especifica qué se desea inferir mediante tres primitivas nativas diseñadas para cubrir decisiones discretas, escalas ordinales y afirmaciones binarias:
| Primitiva | Tipo de decisión | Cálculo matemático principal | Campo clave de salida |
|---|---|---|---|
Choice | Selección entre K alternativas distintas | Softmax sobre logits y arg max | choice, probabilities y confidence |
Score | Evaluación en escala ordenada (0 a K - 1) | Valor esperado E[X] = ∑ᵢ i · pᵢ | score, legend, probabilities y confidence |
Noul | Pregunta binaria sí/no | Parámetro p en Bernoulli(p) | noul (probabilidad continua entre 0 y 1) |
En la primitiva Choice, el modelo asigna un logit z₁, …, z_K a cada opción, calcula sus probabilidades con pᵢ = exp(zᵢ) / ∑ⱼ exp(zⱼ) —de modo que sumen 1— y selecciona ŷ = arg maxᵢ pᵢ. Al evaluar un reclamo de cobro doble con autotrust/GEV-26B-Decide entre tres departamentos, el modelo asigna 0,9983 a billing, 0,0010 a technical y 0,0007 a sales.
Cuando la respuesta sigue un orden gradual, Score evita quedarse únicamente con la categoría ganadora y calcula el valor esperado del índice de nivel. Sobre tres grados de urgencia (low, medium, high), las probabilidades ilustrativas 0,01, 0,26 y 0,72 producen una puntuación esperada de 1,7 (0×0,01 + 1×0,26 + 2×0,72), reflejando la esperanza de la distribución y no un nivel intermedio ficticio.
La tercera primitiva, Noul —cuyo nombre deriva de la distribución de Bernoulli—, modela preguntas cerradas como Y ~ Bernoulli(p), con P(Y = 1) = p y P(Y = 0) = 1 - p. En lugar de muestrear un booleano aleatorio, devuelve directamente el parámetro de probabilidad (como 0,9947 al consultar si el usuario pide reembolso, o 0,92 frente a 0,08 para «No»), delegando el umbral de acción a la aplicación.
Además, tanto Choice como Score devuelven el campo confidence, que mide cuán concentrada está la creencia del modelo respecto a una distribución uniforme 1 / K mediante la fórmula C = (p_max - 1/K) / (1 - 1/K). Así, una distribución uniforme marca 0 y una certeza total marca 1; en el ejemplo de Choice (p_max = 0,998 con K = 3), la confianza llega a 0,997, mientras que en la ejecución de Score (1,705) desciende a 0,558.
Ecosistema en Hugging Face: transformers, llama.cpp, Hub y entrenamiento
La estrategia de Hugging Face busca acordar una interfaz común sin imponer una arquitectura interna única, permitiendo que convivan cabezas de puntuación conjunta sobre esquemas, lecturas separadas sobre backbones de LLM, variantes compactas de borde o modelos multimodales. Con ese contrato compartido, cualquier motor de inferencia o biblioteca de entrenamiento puede operar sobre las mismas primitivas.
En inferencia en Python, transformers incorpora las clases DecisionPipeline, AutoModelForDecision y DecisionConfig, accesibles mediante pipeline("decision", model="autotrust/GEV-26B-Decide") sobre JevForDecision en bfloat16 y cuda. Al instalar transformers[serving] y ejecutar transformers serve, el servidor expone en el puerto 8000 la ruta /v1/systemone, capaz de procesar múltiples preguntas tipadas en una sola llamada con 0 tokens generados (input_tokens: 148, output_tokens: 0).
{
  "model": "autotrust/GEV-26B-Decide",
  "state": "I was charged twice. Please refund me today.",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "billing": "Payments and refunds",
        "technical": "Bugs and technical issues",
        "sales": "Pricing and subscriptions"
      }
    },
    "urgency": {
      "type": "score",
      "instructions": "How urgent is the request?",
      "criteria": ["low", "medium", "high"]
    },
    "refund": {
      "type": "noul",
      "instructions": "Is the customer requesting a refund?"
    }
  }
}
La API de transformers funciona incluso sobre modelos de lenguaje autorregresivos compatibles sin necesidad de reentrenarlos. Internamente, la biblioteca construye los prompts de decisión, evalúa los logits de cada etiqueta de respuesta en un único forward pass por lotes y aplica softmax sin generar texto.
En paralelo, llama.cpp adopta el mismo contrato HTTP /v1/systemone —documentado en la integración publicada junto a ggml-org—, permitiendo servir modelos cuantizados como ggml-org/Kev-4B-GGUF mediante llama serve -hf ggml-org/Kev-4B-GGUF en el puerto predeterminado 9931. Para localizar modelos compatibles de arquitecturas tan dispares como codificadores ModernBERT o backbones generativos, el Hub habilitó la etiqueta decision-model.
En el apartado de entrenamiento, cualquier modelo puede adaptarse mediante AutoModelForDecision y la API Trainer de transformers. En el ejemplo con autotrust/JEV-9B, model.decision_config.prepare_inputs transforma cada petición en tensores de entrada equivalentes a los de inferencia y una subclase DecisionTrainer optimiza preguntas choice con pérdida de entropía cruzada (F.cross_entropy) sobre los logits de las opciones (learning_rate=1e-3, max_steps=30).
Para evitar esa configuración manual, la comunidad desarrolla soporte nativo en TRL mediante la solicitud de cambios huggingface/trl#8040, aún abierta al anunciarse la especificación. Además, Unsloth ofrece una receta para convertir modelos generativos como Qwen en decision models mediante ajuste fino con LoRA y una cabeza de puntuación dedicada.
Al elevar las decisiones tipadas y sus probabilidades calibradas a salidas nativas de software, este enfoque reduce la latencia y la fragilidad estructural frente al prompting con JSON abierto. Aunque las aplicaciones siguen siendo responsables de fijar sus propios umbrales de acción sobre las salidas probabilísticas, el estándar sienta una base interoperable entre bibliotecas de entrenamiento, formatos GGUF y servidores locales.
Fuente: Decision Models in Hugging Face