IBM Granite 4.1 incorpora LLMON, su lenguaje de marcado nativo contra ataques de indirect prompt injection
IBM presenta Granite 4.1 3B y 8B con LLMON, un marcado nativo que separa instrucciones y datos para frenar ataques de indirect prompt injection.
IBM presentó LLMON (LLM Object Notation, pronunciado «lemon»), un lenguaje de marcado nativo para modelos de lenguaje diseñado para delimitar de forma explícita las instrucciones frente a los datos dentro de la ventana de contexto. La compañía liberó dos modelos experimentales preliminares basados en Granite 4.1 de 3.000 y 8.000 millones de parámetros (granite-4.1-3b-LLMON-preview y granite-4.1-8b-LLMON-preview), según detalla el equipo de IBM Granite en el blog técnico de Hugging Face.
Junto a los dos pesos preliminares, IBM publicó el repositorio oficial de LLMON en GitHub con herramientas, plantillas y flujos de trabajo. El lanzamiento también incluye integración automática en el framework Mellea y dos artículos de investigación disponibles en arXiv (arXiv:2610.38120 y arXiv:2603.22519).
Por qué falla JSON y cómo LLMON separa la estructura del contenido
Durante ejecuciones prolongadas, la ventana de contexto de un LLM mezcla elementos heterogéneos como el system prompt, turnos previos de conversación, documentos recuperados, respuestas de herramientas, restricciones de formato y cadenas de razonamiento. En la práctica, gran parte de esa jerarquía queda implícita o se serializa en JSON, un formato concebido para analizadores sintácticos (parsers) deterministas y no para modelos de lenguaje causales.
En JSON, el tokenizer no está obligado a respetar la gramática y la estructura depende de caracteres ordinarios como llaves, comillas y dos puntos. Para un modelo, una comilla que cierra un campo y una comilla dentro de un texto normal corresponden al mismo token, mientras que las reglas de escape se reducen a patrones estadísticos. Además, la profundidad de anidamiento se infiere contando corchetes o llaves, una operación en la que los transformers pierden precisión sobre secuencias extensas.
LLMON adopta una sintaxis similar a XML, pero sustituye los delimitadores textuales por seis tokens especiales reservados en el vocabulario del tokenizer. De este modo, el marcado estructural y el contenido semántico utilizan partes completamente disjuntas del vocabulario, con etiquetas declaradas al inicio de cada bloque y fronteras explícitas entre segmentos. Las estructuras anidadas se expresan de forma local para evitar que el modelo deba rastrear jerarquías a larga distancia.
Para facilitar la adopción en canalizaciones existentes, el proyecto incorpora herramientas de conversión y cuadernos de ejemplo capaces de transformar documentos JSON a LLMON y revertirlos sin pérdida de datos (lossless). Asimismo, los bloques reciben identificadores únicos de dos caracteres tomados de un conjunto fijo que el tokenizer codifica como tokens individuales, de modo que referenciar cualquier bloque en el contexto cuesta siempre exactamente dos tokens.
Integración con chat templates y vinculación mediante bloques exec
Lejos de sustituir los chat templates convencionales, LLMON los enriquece al definir qué significa cada componente y cómo se relaciona con el resto de la conversación. Mientras un formato estándar solo distingue roles como system, user y assistant, el chat template incluido en los modelos preliminares de Granite 4.1 permite nombrar subcomponentes dentro de un mismo turno —como instruction, data y requirement— sin requerir tuberías de conversión externas.
Cada fragmento recibe un indicador booleano exec (True o False). Los elementos marcados como True quedan enlazados al bloque final exec, que especifica qué instrucción debe ejecutarse, sobre qué entradas opera, qué restricciones la rigen y en qué bloque debe responder el asistente; los bloques marcados como False permanecen visibles en el contexto sin ser referenciados.
messages = [ { "role": "user",
               "instruction": [{ "value": "Write a short paragraph about", "exec": True }],
               "data": [{ "value": "IBM Company", "exec": True }],
               "requirement": [ {"value": "Use less than 10 words", "exec": True},
                                {"value": "Do not use commas", "exec": True}]
             } ]
Al pasar esa estructura a apply_chat_template, el modelo recibe cinco bloques independientes y direccionables vinculados por un sexto bloque de ejecución (exec), en lugar de una cadena plana donde debe adivinar cuál parte es la orden y cuál es el insumo. Para mayor legibilidad, la siguiente salida añade saltos de línea y sangrías que la plantilla real omite:
<|open|>instr<|:|>Ȗ<|close|>Write a short paragraph about<|open_end|>
<|open|>data<|:|>ä¦<|close|>IBM Company<|open_end|>
<|open|>req<|:|>Á¼<|close|>Use less than 10 words<|open_end|>
<|open|>req<|:|>¢¬<|close|>Do not use commas<|open_end|>
<|open|>exec<|:|>ÄÐ<|close|>
    <|open|>exec<|.|>instruction<|close|>instr<|:|>Ȗ<|open_end|>
    <|open|>exec<|.|>input<|close|>data<|:|>ä¦<|open_end|>
    <|open|>exec<|.|>requirement<|close|>req<|:|>Á¼<|open_end|>
    <|open|>exec<|.|>requirement<|close|>req<|:|>¢¬<|open_end|>
    <|open|>exec<|.|>output<|close|>assistant<|:|>ãø<|open_end|>
<|open_end|>
<|open|>assistant<|:|>ãø<|close|>
Cuando un componente contiene a su vez un objeto estructurado, como un documento JSON, la biblioteca LLMON-converters desciende un nivel adicional y lo convierte en bloques tipados y direccionables individualmente en vez de tratarlo como una cadena opaca. Además, el enlace explícito de cada instrucción a sus datos impide que pasajes irrelevantes, turnos antiguos o salidas previas de herramientas contaminen la respuesta.
Protección frente a indirect prompt injection y paridad de capacidad
El vector de indirect prompt injection ocurre cuando un atacante oculta órdenes maliciosas dentro de cargas de datos legítimas, como un documento recuperado, la salida de una herramienta o entradas proporcionadas por usuarios. Al separar formalmente el canal de instrucciones del canal de datos, LLMON está diseñado para que el modelo ignore las órdenes incrustadas en la información consultada.
IBM evaluó sus modelos preliminares frente a sistemas propietarios y de código abierto (open source) en la prueba comparativa OPI, que inserta inyecciones bajo distintas estrategias de ataque dentro de tareas clásicas de procesamiento del lenguaje natural. La métrica empleada es la robustez (1 − tasa de éxito del ataque), entendida como la proporción de intentos en los que el modelo no ejecuta la instrucción infiltrada.
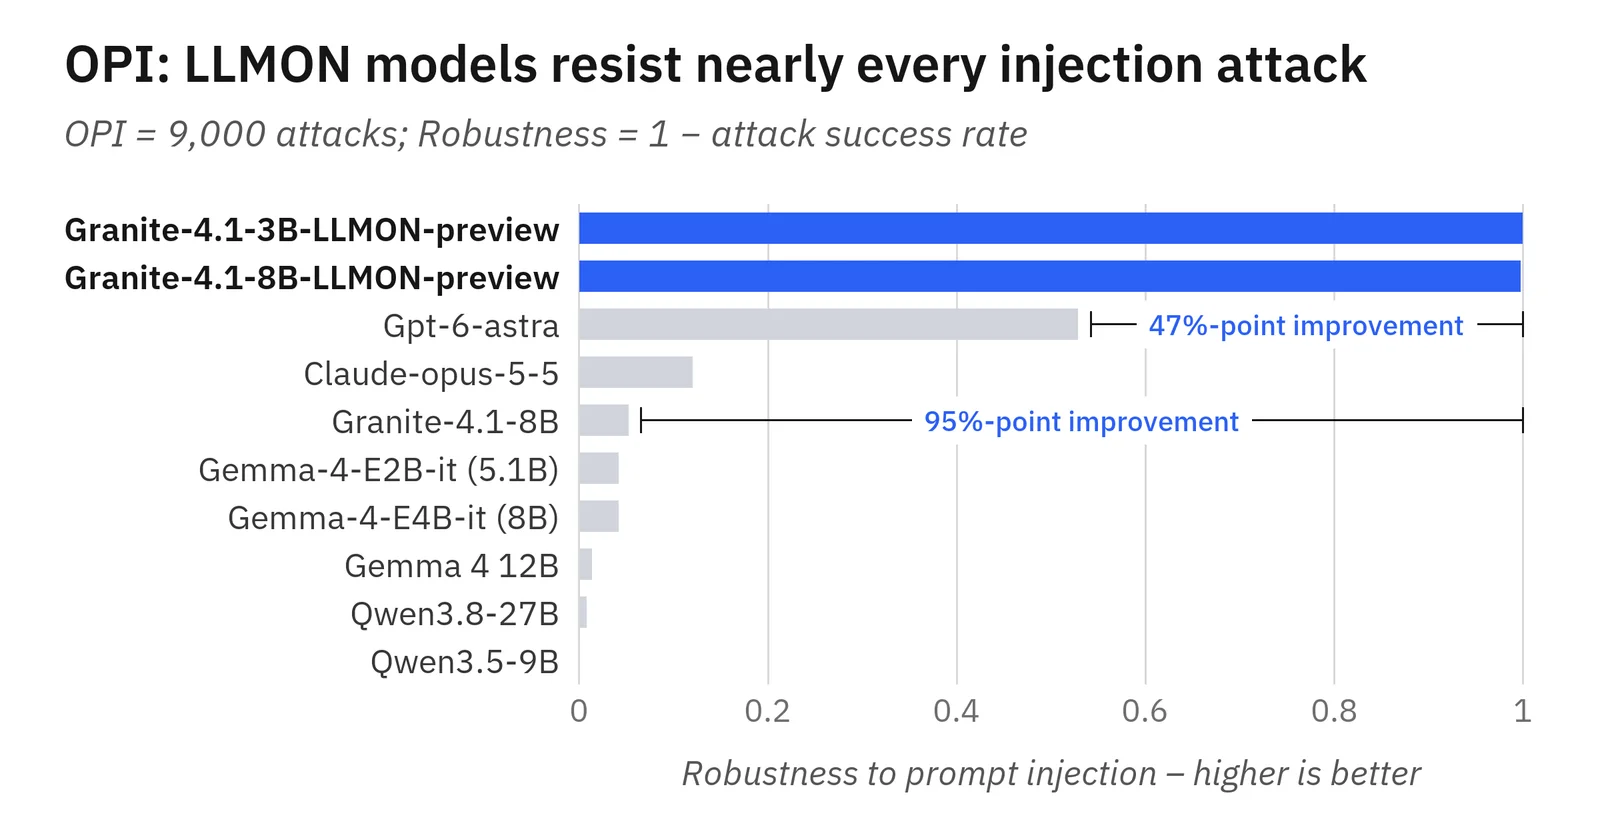
Robustez frente a ataques de indirect prompt injection en el benchmark OPI frente a modelos abiertos y propietarios evaluados (IBM Granite / Hugging Face).
La compañía verificó tendencias equivalentes en las evaluaciones ASB y StruQ, aunque matiza que los tres conjuntos miden ataques estáticos de inyección indirecta. Para amenazas más complejas, el equipo de investigación sigue trabajando en reforzar la defensa frente a ataques adaptativos que se despliegan a lo largo de múltiples turnos conversacionales.
A diferencia de otras medidas defensivas que penalizan la utilidad general, las pruebas estándar confirman que esta ganancia de seguridad no degrada las capacidades base frente a la familia Granite 4.1 Instruct. Quienes ya empleen Granite 4.1 en sus versiones de menor y mayor tamaño pueden sustituir el modelo por la edición LLMON preliminar nombrando las partes del turno para obtener una resistencia muy superior con desempeño general equivalente.
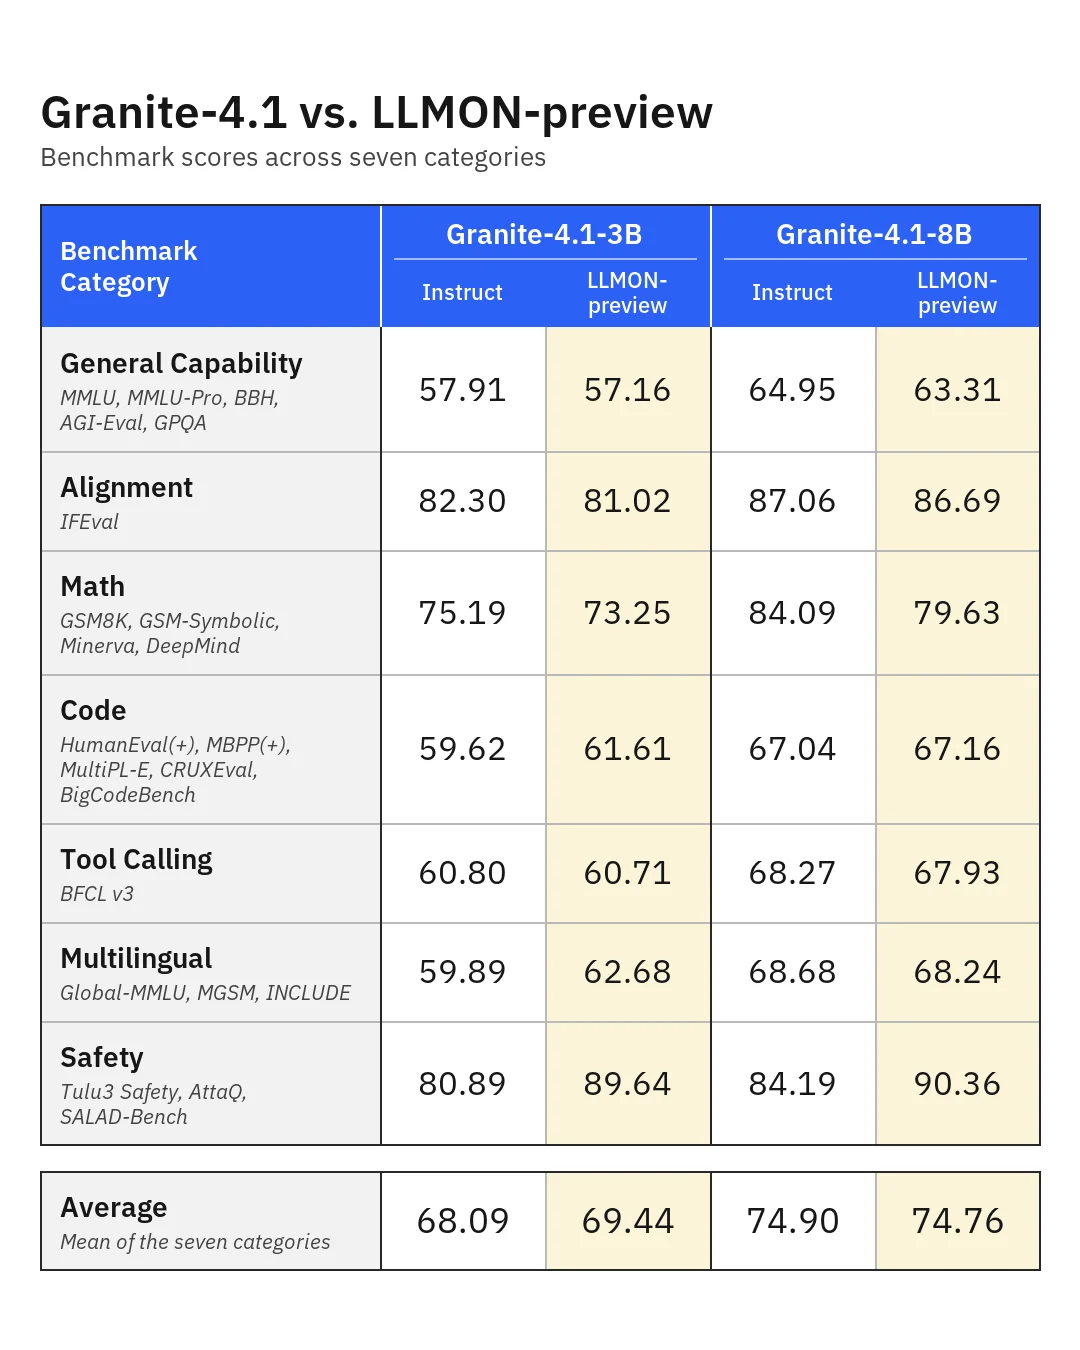
Comparativa de capacidad general en categorías estándar entre Granite 4.1 Instruct y las versiones preliminares con LLMON (IBM Granite / Hugging Face).
En la siguiente tabla se resumen las variantes publicadas, los resultados frente a ataques de inyección y la paridad de rendimiento registrados por el equipo de IBM Granite:
| Modelo o evaluación | Referencia comparativa | Resultado documentado |
|---|---|---|
granite-4.1-3b-LLMON-preview | Derivado de Granite 4.1 base (3.000 millones de parámetros) | Vista previa experimental con chat template LLMON nativo |
granite-4.1-8b-LLMON-preview | Derivado de Granite 4.1 base (8.000 millones de parámetros) | Vista previa experimental orientada a evaluación, no a producción |
| Prueba OPI (arXiv:2310.12815) | Frente al mejor modelo de frontera evaluado | Evita un 47 % más de ataques de indirect prompt injection |
| Prueba OPI (arXiv:2310.12815) | Frente al mejor modelo open source evaluado | Evita un 95 % más de ataques; tasa de éxito cercana a cero |
| Pruebas ASB y StruQ | Inyección indirecta estática en flujos con datos | Tendencia equivalente de alta robustez frente a modelos sin LLMON |
| Capacidad general estándar | Frente a Granite 4.1 Instruct | Desempeño equivalente sin penalización por seguridad |
Entrenamiento desde checkpoints base y modelo de privilegios
A diferencia de los adaptadores superpuestos a formatos previos, ambos modelos parten de los checkpoints base de Granite 4.1 para aprender la sintaxis LLMON de forma nativa durante el post-training. Tras instalar los seis delimitadores en el tokenizer, IBM reserializó un corpus convencional de instruction-tuning —que abarca diálogo, escenarios multi-turn, generación aumentada por recuperación (RAG) y tool calling— en bloques direccionables con su bloque exec correspondiente.
Para reforzar la obediencia estricta a la estructura, el equipo aumentó los datos con bloques señuelo (decoy) de instrucciones y datos que permanecen en el contexto sin estar enlazados en exec, manteniendo intacta la respuesta esperada. Posteriormente aplicó cinco etapas secuenciales de aprendizaje por refuerzo mediante GRPO —cubriendo razonamiento multidominio, RLHF, calibración de conocimiento y matemáticas— seguidas de una etapa final de DPO sobre 1.000 pares de preferencia on-policy generados a partir de las respuestas del propio modelo ante intentos de inyección.
De esta arquitectura emerge una regla de privilegios sin necesidad de un guardrail externo añadido: toda instrucción alcanzada mediante un bloque exec tiene autoridad de ejecución, mientras que el material recibido como entrada (datos, documentos, esquemas o resultados de herramientas) se interpreta únicamente como texto para leer. Además, los fragmentos no referenciados en exec quedan ignorados, un comportamiento cuya activación interna puede explorarse en el entorno interactivo LLMON Attention Visualization en Hugging Face Spaces.
Con todo, IBM subraya el límite técnico de este enfoque frente a defensas criptográficas o deterministas: «Se trata de un comportamiento aprendido, no de una garantía impuesta». Por ello, tanto los modelos como el conjunto de herramientas se publican con etiqueta de vista previa experimental, aptos para evaluación técnica pero no recomendados todavía para entornos de producción.
Vocabularios propios con LoRA y ecosistema para desarrolladores
La especificación LLMON no impone un esquema cerrado, sino que permite definir nombres de etiquetas y jerarquías adaptadas a cada dominio mediante el ajuste fino (fine-tuning) de adaptadores LoRA. IBM demostró esta flexibilidad en ScienceWorld, un benchmark basado en texto donde un agente resuelve tareas científicas elementales —como hervir agua— emitiendo una orden por turno ante un simulador que puntúa cada paso.
Para modelar esas trayectorias de planificación, los investigadores diseñaron un vocabulario específico integrado por etiquetas como instr.task.goal, req.planning_policy.rule, data.state.room, data.state.inventory y assistant.next_action. Tras renderizar las soluciones de referencia con ese esquema y entrenar un adaptador LoRA sobre el modelo LLMON, el agente fue capaz de completar partidas inéditas (held-out) generando su siguiente acción directamente en el vocabulario personalizado.
El flujo completo para reproducir ese experimento —desde la conversión de trayectorias hasta la evaluación comparativa frente al modelo base sin entrenar— está documentado en un cuaderno de ajuste LoRA para ScienceWorld y en un segundo cuaderno para agentes con uso de herramientas. Junto con el marco Mellea, los repositorios abiertos y los pesos preliminares en Hugging Face, el equipo invitó a la comunidad a reportar casos de uso y fallos detectados a través de GitHub Discussions.
Fuente: Hugging Face