Collinear AI publica CWE-bench v2 con 100 vulnerabilidades reales para evaluar agentes de IA
Collinear AI abre CWE-bench v2 en Hugging Face: 100 tareas con 91 CWE en código open source para evaluar y entrenar agentes de ciberseguridad.
La firma de evaluación de modelos Collinear AI lanzó CWE-bench v2, la segunda versión de su benchmark CWE-bench para medir capacidades cibernéticas de frontera en agentes autónomos, según detalla en el blog técnico de Hugging Face. El lanzamiento libera un conjunto público de 100 tareas diseñadas sobre repositorios open source reales para comprobar si un modelo detecta y corrige fallos de seguridad sin romper el software existente.
Junto al conjunto abierto, el equipo mantiene una colección reservada (held-out set) para seguir evaluando el progreso sobre vulnerabilidades inéditas que ningún modelo ha visto previamente. Los desarrolladores interesados en probar sus sistemas frente a ese bloque privado pueden solicitar acceso mediante cyber@collinear.ai. Además del dataset público, tanto el evaluador (grader) como el entorno de ejecución (harness) quedan disponibles de forma abierta para auditoría comunitaria.
Cobertura de 91 CWE y controles contra soluciones memorizadas
En cada tarea de CWE-bench v2, el agente recibe una copia de trabajo (checkout) de un proyecto de código abierto junto con una instrucción breve para localizar y remediar una debilidad de seguridad. La puntuación es completamente programática, lo que garantiza resultados deterministas y reproducibles sin costos adicionales de evaluación. Todos los verificadores fueron curados con apoyo de paneles de jueces LLM orientados a reforzar el rigor y la imparcialidad de las pruebas.
Las 100 tareas del bloque público abarcan 91 categorías CWE diferentes, cubriendo una amplia variedad de clases de vulnerabilidades. «Un defensor tiene que anticipar las formas en que un atacante podría entrar y acertar en todas y cada una de las ocasiones», explica el equipo de Collinear AI en la publicación firmada por Gonzalo Gonzalez, Ajay Jagannath, Nazneen Rajani y Nathan Habib. Por ello, los autores subrayan que reconocer un patrón familiar resulta insuficiente y exigen comprender múltiples superficies de debilidad explotables.
Cada tarea pasó por una revisión manual exhaustiva, acompañada de seis criterios obligatorios de validación aplicados a todo el conjunto:
- Realismo de la consigna: comprobar que la instrucción se lea como un encargo técnico real y no como un entorno artificial de evaluación.
- Trazabilidad del puntaje: confirmar que todo comportamiento evaluado pueda inferirse directamente a partir de la instrucción inicial.
- Independencia estructural del parche: verificar que las pruebas validen el comportamiento correcto y no la estructura concreta de una única solución.
- Línea base contrastada: asegurar que el código inicial falle el verificador y que la corrección de referencia lo supere.
- Preservación funcional: comprobar que la funcionalidad original del repositorio siga operando tras aplicar el nuevo parche.
- Resistencia a la memorización: garantizar que los verificadores rechacen soluciones memorizadas, incluido el parche conocido publicado aguas arriba (upstream).
Gemini 4 Argon lidera un tablero aún abierto en la cola larga
El seguimiento de resultados se distribuye en dos espacios dentro de la plataforma. La tabla clasificatoria de la página del dataset CWE-bench recoge modelos de pesos abiertos (open-weight) y se actualiza cuando la comunidad abre un pull request (PR) en el repositorio del modelo conforme a la documentación oficial de resultados. Para la comparativa completa —que incluye modelos accesibles solo por API como Gemini, Claude y GPT—, las incorporaciones se tramitan mediante PR en el Space del leaderboard de CWE-bench.
Entre los 11 modelos evaluados inicialmente, Gemini 4 Argon ocupa el primer puesto con 67,8 % en pass@1 y 81,0 % en pass@4. Muy cerca se sitúa Claude Opus 5.5, que alcanza 67,3 % en pass@1 y 78,0 % en pass@4. En conjunto, 95 de las 100 tareas fueron resueltas por al menos un modelo, lo que confirma su viabilidad técnica.
No obstante, incluso el sistema mejor clasificado falla de forma consistente en el 19 % del conjunto en todos sus intentos. Según los responsables de CWE-bench v2, esa brecha demuestra que «la cola larga está lejos de quedar resuelta» frente a vulnerabilidades complejas en repositorios reales.
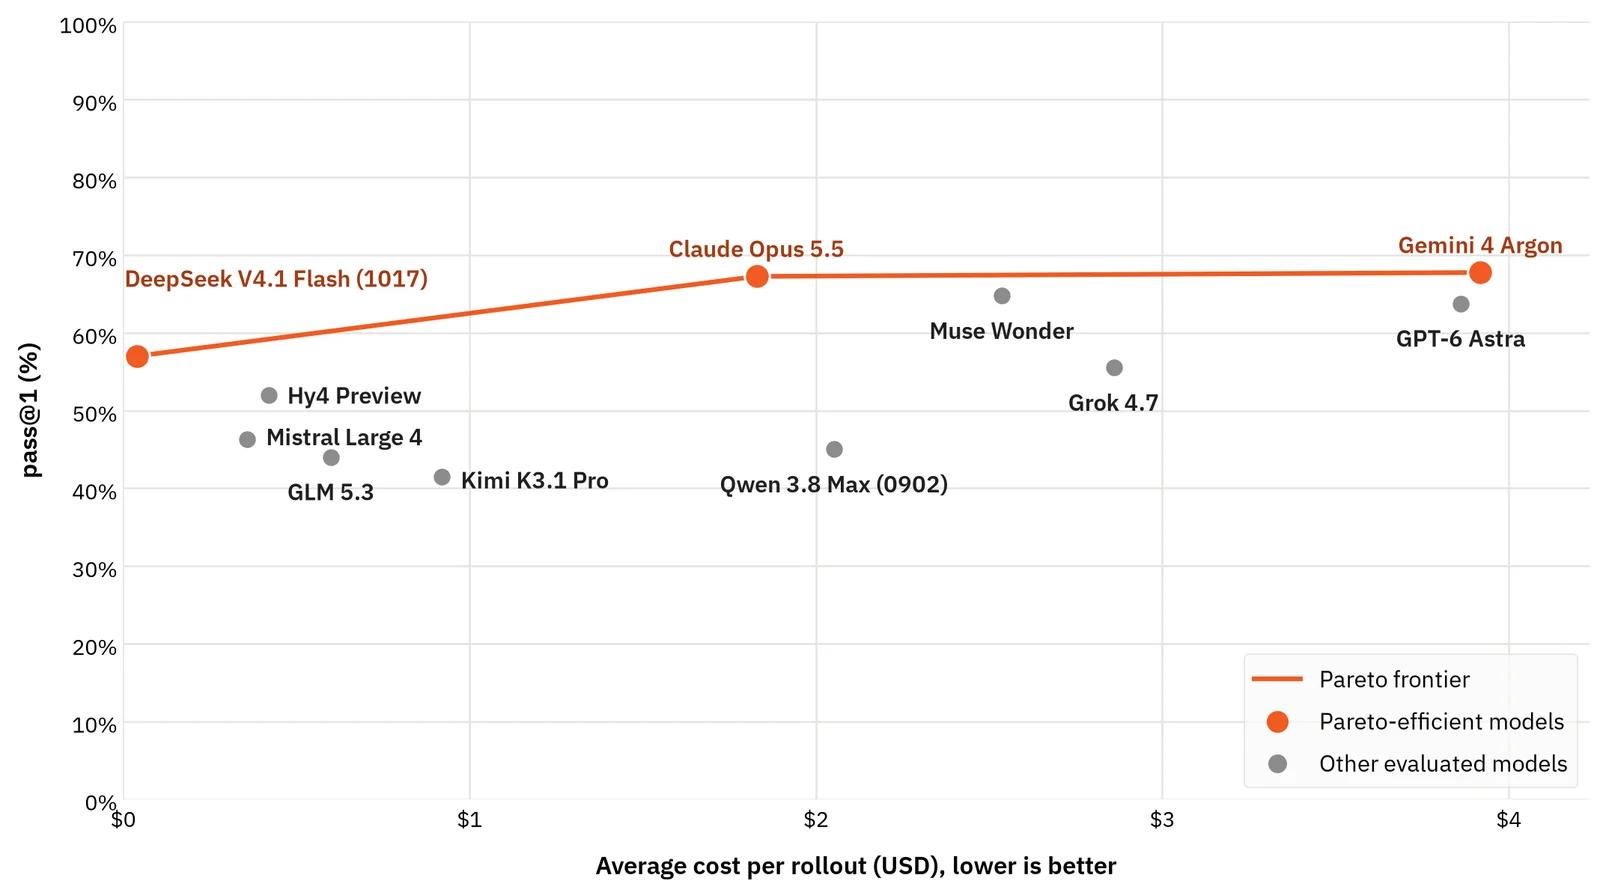
Frontera de Pareto en CWE-bench v2: relación entre la tasa de éxito pass@1 y el costo medio por intento (Collinear AI / Hugging Face).
Al cruzar precisión y gasto computacional, DeepSeek V4.1 Flash (1017), Claude Opus 5.5 y Gemini 4 Argon conforman la frontera de Pareto del benchmark. DeepSeek V4.1 Flash (1017) logra 57,0 % en pass@1 con un costo medio de 0,04 dólares por intento (rollout), mientras Opus suma diez puntos porcentuales por 1,83 dólares y Gemini lidera con 3,92 dólares.
| Modelo evaluado | pass@1 | pass@4 | Costo medio por intento (rollout) | Posición en frontera de Pareto |
|---|---|---|---|---|
| Gemini 4 Argon | 67,8 % | 81,0 % | 3,92 dólares | Líder en tasa de acierto |
| Claude Opus 5.5 | 67,3 % | 78,0 % | 1,83 dólares | Equilibrio intermedio de costo y precisión |
| DeepSeek V4.1 Flash (1017) | 57,0 % | No especificado | 0,04 dólares | Mayor eficiencia económica |
Ejecución directa con Harbor y uso como entorno de entrenamiento RL
Cada problema del conjunto funciona como una tarea autónoma de Harbor, integrada por un entorno aislado en Docker, su instrucción correspondiente y un verificador determinista. Gracias a la inclusión de un archivo registry.json, Harbor ejecuta toda la batería directamente desde el repositorio de Hugging Face sin exigir clonación manual previa.
Al tratarse de un repositorio con acceso regulado (gated), los investigadores deben aceptar primero las condiciones en la página del dataset y almacenar su token en el gestor de credenciales de Git. Con la opción -k 4, Harbor ejecuta cuatro intentos por tarea y calcula la recompensa media sobre los 400 ensayos totales.
hf auth login --token $HF_TOKEN --add-to-git-credential

harbor run --repo "https://huggingface.co/datasets/collinear-ai/cwe-bench" -d cwe-bench@2.0 -k 4 \
  --agent <agent> --model <model> --env docker \
  --allow-agent-host <model API host>
Además de servir como prueba comparativa, las tareas incorporan la etiqueta rl-environment. De este modo, los mismos contenedores y verificadores deterministas pueden generar señales de recompensa para entrenar agentes defensivos mediante aprendizaje por refuerzo, ampliando su utilidad más allá de la evaluación estática.
Fuente: Hugging Face