IBM Research presenta Palette, un modelo LoRA de 20.000 millones de parámetros especializado en diseñar y reparar presentaciones
IBM Research presenta Palette: modelo LoRA de 20.000 millones de parámetros que diseña y repara presentaciones con identidad propia.
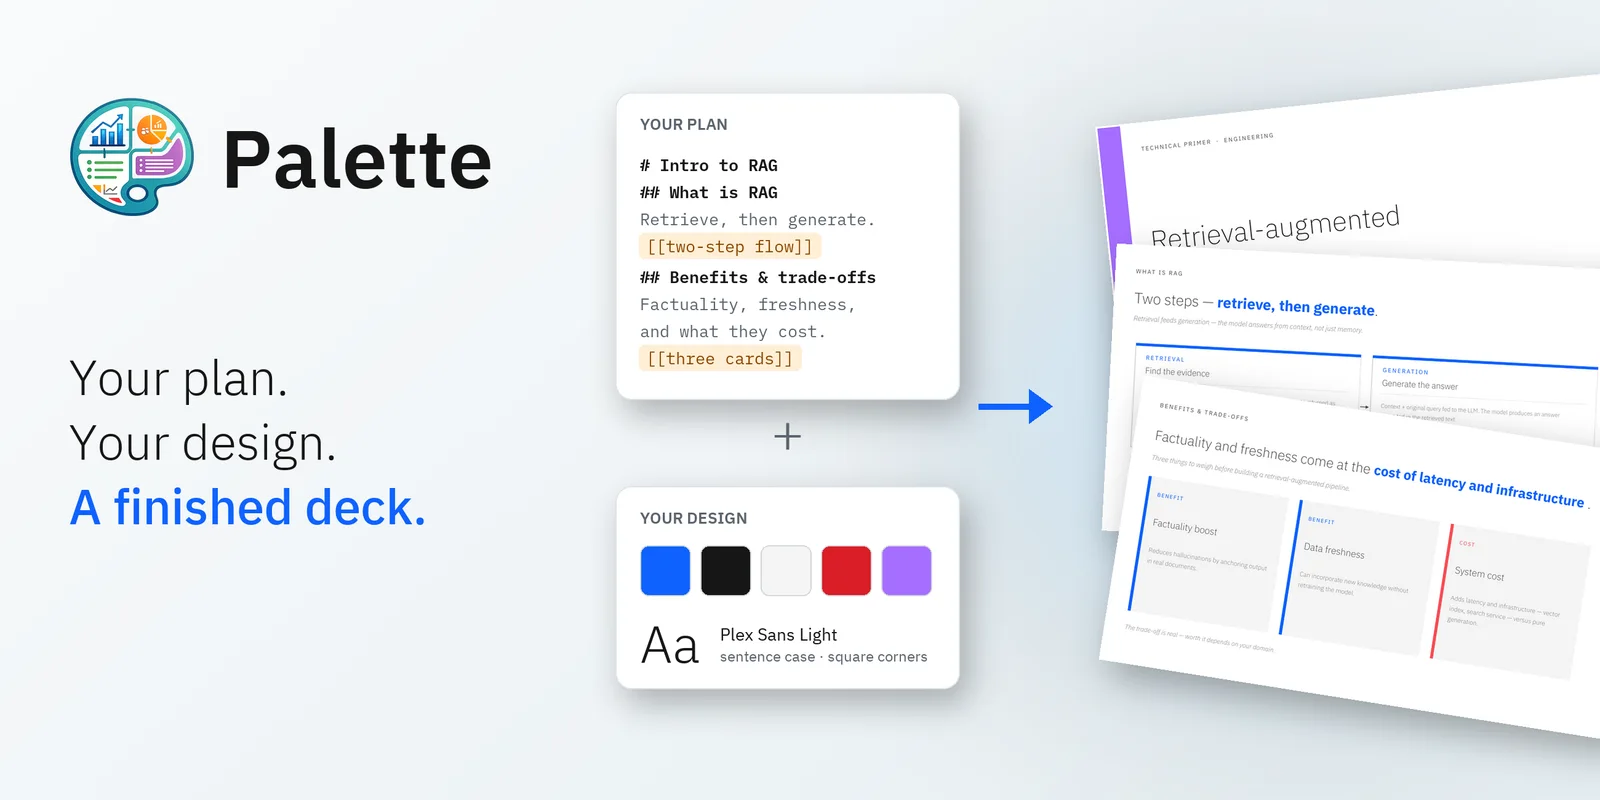
Los modelos fundacionales generan presentaciones aceptables de forma aislada, pero al pedir varias seguidas repiten un estilo genérico que delata su origen sintético y se desvía de las plantillas corporativas mediante cualquier prompt. Además, numerosas organizaciones manejan documentación confidencial que no puede salir hacia APIs externas. Frente a ese límite, IBM Research desarrolló Palette, un modelo de 20.000 millones de parámetros de pesos abiertos (open weights) ajustado para diseñar diapositivas bajo una identidad visual propia.
Según detallan los investigadores Praveen Venkateswaran, Anupama Murthi y Hamid Adebayo en el blog de Hugging Face, el proyecto demuestra que un modelo compacto autoalojado (self-hosted) puede competir con sistemas frontier si combina datos sintéticos especializados y un arnés de verificación posterior. La arquitectura entrena un adaptador LoRA sobre el sistema visual IBM Design Language y separa la planificación editorial de la codificación geométrica. En las pruebas sobre PresentBench, Palette alcanzó el primer puesto en dos de los tres dominios evaluados.
Por qué fallan los modelos pequeños al diseñar diapositivas
Aunque una presentación parezca simple, construirla automáticamente exige resolver tres obstáculos en los que los modelos abiertos compactos suelen fracasar. Sin supervisión estructural, sus resultados presentan títulos invisibles frente al fondo, texto que rebasa los márgenes (overflow) y bloques gráficos superpuestos entre sí (overlaps). El equipo de IBM Research identificó tres causas concretas detrás de estos fallos recurrentes:
- Cálculo geométrico a ciegas: el modelo no dibuja directamente sobre un lienzo visual, sino que escribe código con coordenadas x, y, anchura y tamaño tipográfico; determinar si un título de 75 caracteres cabe en dos líneas a 56 puntos ocurre sin retroalimentación visual previa al renderizado.
- Doble toma de decisiones simultánea: en una única pasada sobre 10 a 20 diapositivas, el sistema debe ejercer criterio editorial —qué contenido recortar y si conviene una tabla o un gráfico— mientras resuelve la precisión espacial manteniendo paleta y tipografía coherentes.
- Ausencia de corpus de proceso: abundan presentaciones terminadas en línea, pero no conjuntos públicos que documenten las decisiones intermedias de diseño ni el código que generó cada lámina.
Arquitectura dual con un único adaptador LoRA
Para replicar el flujo humano de trabajo, Palette divide la creación en dos roles especializados servidos por un único adaptador LoRA, evitando el coste de un fine-tuning completo sin alterar las capacidades generales del modelo base. Primero se define la narrativa global y la estructura, y después se programa cada lámina de forma independiente:
- Diseñador (designer): lee el plan de entrada y genera un brief estructurado en formato JSON que fija la paleta, el sistema tipográfico y, para cada diapositiva, su layout, contenido exacto y una breve justificación de diseño.
- Codificador (coder): toma la especificación individual de una diapositiva desde el brief y redacta el código JavaScript en
pptxgenjsnecesario para dibujarla, precedido por su razonamiento geométrico.
Esta separación aporta ventajas operativas directas frente a la generación monolítica. Como el brief intermedio es legible y editable, una persona o un agente puede ajustar el layout de una diapositiva puntual sin regenerar toda la presentación. Además, al quedar fijado el contexto de cada lámina antes de escribir código, las llamadas del codificador se ejecutan en paralelo —una por diapositiva—, acelerando entre 6× y 7× esta etapa.
Durante el entrenamiento, los investigadores detectaron un desequilibrio importante en las longitudes de secuencia entre ambos roles. Dado que los ejemplos del codificador son aproximadamente 5 veces más largos que los del diseñador, una mezcla ingenua subentrenaba la fase editorial hasta que sobremuestrearon 5× los ejemplos del diseñador.
Datos sintéticos, razonamiento contrafactual y fidelidad
Al carecer de un corpus público de planes, justificaciones y código de diseño, IBM Research generó alrededor de 1.000 presentaciones que suman cerca de 10.000 diapositivas mediante un modelo teacher abierto de gran tamaño. Cada unidad parte de una receta que controla género, extensión, layouts y directivas, combinando esquemas ordenados con volcados de texto sin depurar (raw content dumps) para enseñar a sintetizar.
Cada ejemplo incorpora razonamiento contrafactual: la traza evalúa alternativas descartadas y explica por qué se rechazaron para que el modelo asimile la regla detrás de la decisión. En el plano editorial, una justificación típica del diseñador señala: «Ingresos de cuatro trimestres, con una tendencia alcista clara. Consideré una tabla, pero el propósito de esta diapositiva es la tendencia y no las cifras exactas, así que un gráfico de barras la hace visible de un vistazo».
En el plano espacial, el codificador razona de forma equivalente antes de emitir JavaScript: «El título tiene 62 caracteres. A 44 puntos se dividiría en tres líneas e invadiría el gráfico inferior, así que lo fijé en 36 puntos, que cabe en dos líneas y deja espacio sobre el gráfico».
El bucle de verificación mejora progresivamente el conjunto de datos sin depender únicamente del modelo teacher. Cada presentación sintética se renderiza y se somete al mismo comprobador geométrico empleado en inferencia; las diapositivas defectuosas se reparan y su razonamiento se reescribe de manera contrafactual explicando el fallo original y la corrección aplicada.
El mayor desafío técnico fue garantizar la fidelidad factual cuando faltan datos en el brief, por ejemplo si solicita una tabla de seis por cinco pero solo incluye tres viñetas y el codificador tiende a inventar celdas. El equipo comprobó que añadir reglas prohibitivas al prompt rara vez frenaba esas alucinaciones del teacher. Lo que corrigió el comportamiento de forma fiable fue depurar las presentaciones de referencia incluidas en el prompt, ya que el modelo imita los ejemplos de referencia mucho más que las instrucciones textuales.
Directivas en lenguaje natural con sintaxis de corchetes
Para ofrecer control granular sin reentrenar, Palette admite directivas breves escritas en inglés directamente en el plan y delimitadas entre corchetes dobles ([[ ]]), como [[make this a timeline]]. Sin esa indicación, el modelo representaría una lista de hitos mensuales como tabla; con la directiva, el diseñador la integra en el brief y el codificador traza una línea temporal.
El modelo responde a estas instrucciones porque las recetas sintéticas cubren 12 categorías de directivas redactadas de múltiples maneras equivalentes, enseñando la intención subyacente en lugar de frases rígidas. La siguiente tabla recoge seis ejemplos representativos de estas categorías incluidas en el entrenamiento:
| Categoría | Directiva de ejemplo |
|---|---|
| Diseño (layout) | [[make this a timeline]] |
| Tono | [[be candid, no spin]] |
| Audiencia | [[this is for the board]] |
| Orden | [[lead with the ask]] |
| Exclusión de datos | [[no pricing]] |
| Énfasis | [[highlight the headline number]] |
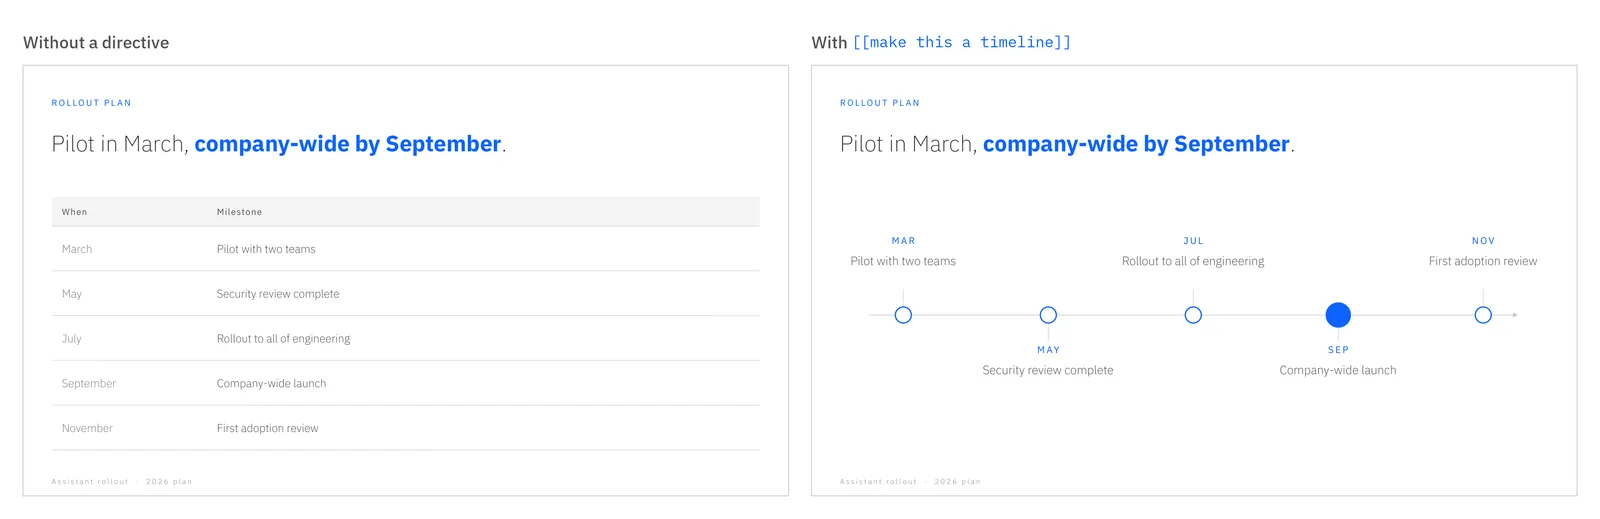
Comparación entre el renderizado estándar de una hoja de ruta (izquierda) y la versión generada tras añadir la directiva [[make this a timeline]] (derecha) (IBM Research / Hugging Face).
Arnés de verificación y reparación segura por defecto
Incluso tras el ajuste fino, el modelo puede producir ocasionalmente títulos con el mismo color que el fondo o tarjetas apiladas. Por ello, Palette nunca entrega directamente la salida sin procesar: cada presentación atraviesa un arnés de verificación y reparación (check-and-repair harness) que combina reglas deterministas, renderizado real y reescritura selectiva.
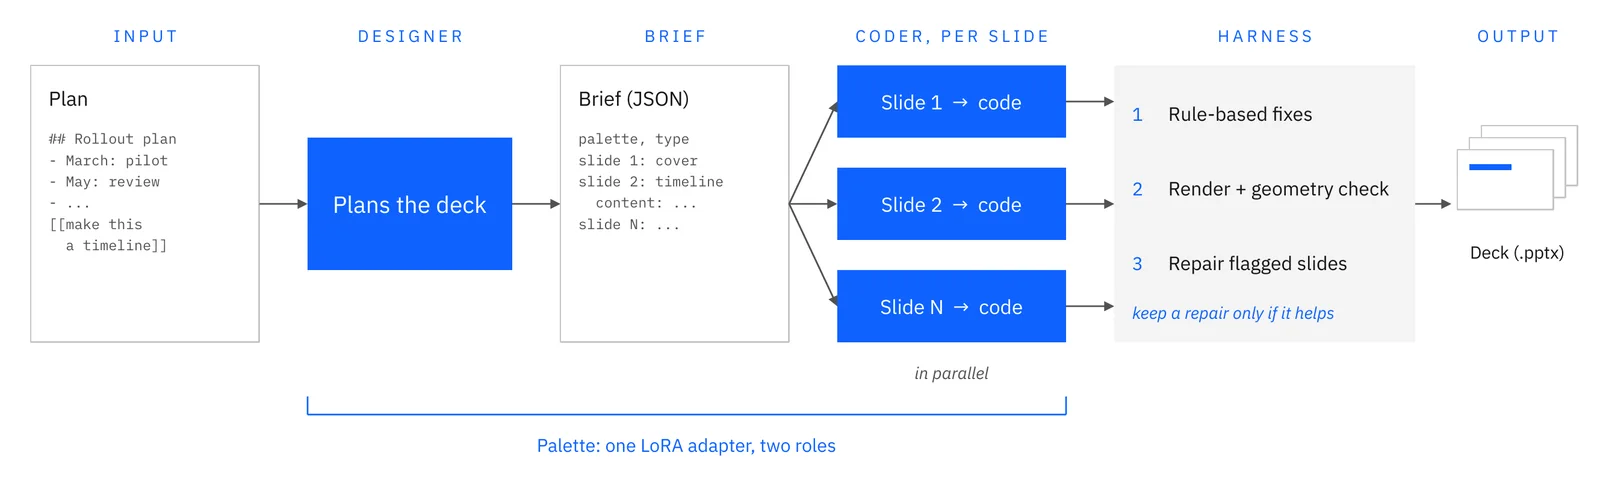
Arquitectura completa de Palette desde el plan inicial hasta el diseñador, los codificadores paralelos por diapositiva y el arnés de verificación y reparación (IBM Research / Hugging Face).
En primer lugar, reglas simples corrigen fallos conocidos, como códigos de color mal formados que teñirían de negro toda la presentación. A continuación, cada diapositiva se renderiza y un verificador geométrico detecta solapamientos, recortes o desbordamientos de texto. Las láminas marcadas pasan a un modelo editor independiente (editor model) encargado de reescribir su código.
La regla de diseño clave del arnés establece que una reescritura solo se conserva si el verificador confirma una mejora medible; de lo contrario, se mantiene la versión original. Esta garantía convierte el arnés en una etapa segura para ejecutarse sobre cualquier presentación, capaz de reparar fallos visuales sin introducir degradaciones.
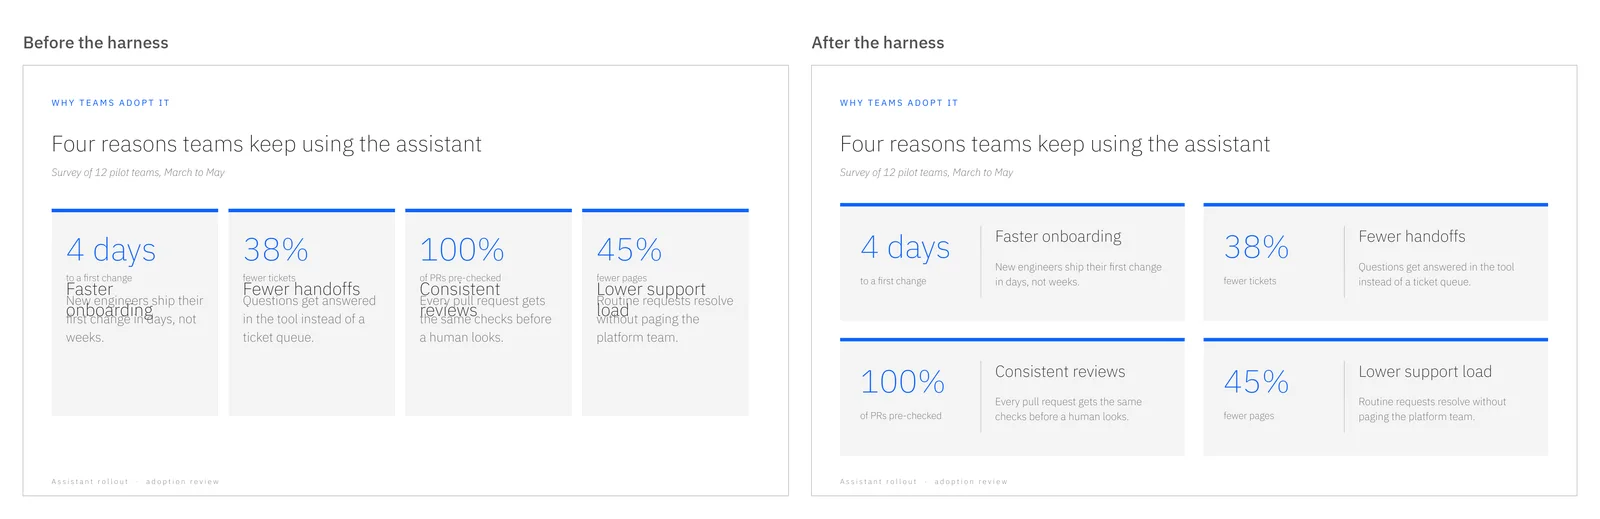
Reparación automática de tarjetas con títulos superpuestos sobre sus descripciones (izquierda) reorganizadas en una cuadrícula limpia de 2×2 (derecha) (IBM Research / Hugging Face).
Resultados en PresentBench frente a sistemas comerciales
El equipo midió el desempeño del sistema en el benchmark PresentBench, que puntúa presentaciones según cinco criterios: fundamentos, diseño visual, completitud, corrección y fidelidad. Como dicho conjunto proporciona un documento fuente en lugar de un guion estructurado, un modelo frontier independiente redactó cada plan previo para que Palette construyera la presentación correspondiente.
Frente a siete sistemas de referencia publicados en el estudio original de PresentBench —entre ellos NotebookLM y Manus 1.6—, Palette destacó en las categorías donde predominan el contenido estructurado y la precisión numérica. Solo cedió terreno en presentaciones narrativas orientadas a discurso oral, manteniéndose competitivo pese a operar con 20.000 millones de parámetros.
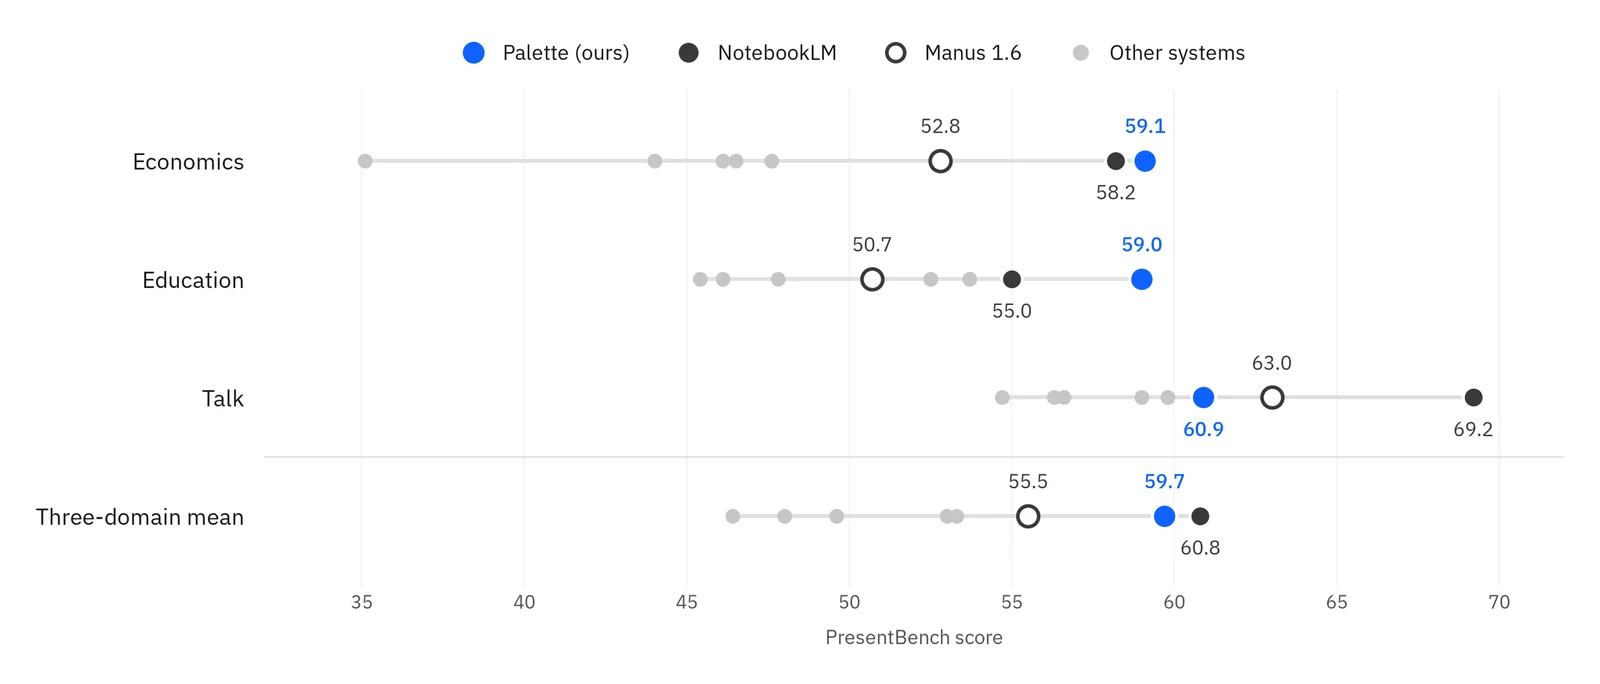
Desempeño por dominio en PresentBench comparando IBM Palette (azul) frente a NotebookLM, Manus 1.6 y otros cinco sistemas evaluados (gris) (IBM Research / Hugging Face).
Los investigadores también midieron por separado la contribución del arnés generando una vez cada presentación del conjunto y evaluándola con y sin etapa de reparación. La siguiente tabla resume las posiciones, puntuaciones y ganancias documentadas:
| Dimensión o dominio evaluado | Alcance / referencia | Resultado de Palette |
|---|---|---|
| Economía (Economics) | Dominio estructurado y numérico de PresentBench | 1.º puesto |
| Educación (Education) | Dominio estructurado y didáctico de PresentBench | 1.º puesto |
| Charlas (Talk) | Presentaciones narrativas y de discurso oral | 3.º puesto (tras dos sistemas cerrados) |
| Media de tres dominios | Comparativa global frente a 7 referencias (NotebookLM: 60,8) | 2.º puesto con 59,7 puntos (−1,1 frente a NotebookLM; delante de Manus 1.6 y otros cinco sistemas) |
| Impacto del arnés | Comparativa con y sin reparación en 131 presentaciones | +3,5 puntos de mejora media |
Pese a estos resultados, IBM Research advierte una carencia relevante en la evaluación actual de modelos para presentaciones. PresentBench mide la calidad general de un conjunto de diapositivas, pero no verifica la adherencia estricta a un lenguaje de diseño corporativo concreto, un vacío que los autores esperan ayudar a cubrir.
Próximos pasos: aprendizaje por refuerzo y extracción documental
Actualmente, el arnés emplea señales económicas y verificables en código —si cada lámina renderiza, si existen solapamientos o desbordamientos y si cada dato remite al brief— únicamente para reparar errores tras la generación. El siguiente objetivo del equipo consiste en convertir esas mismas comprobaciones en recompensas para aprendizaje por refuerzo estilo GRPO, de modo que el modelo evite los fallos desde origen. Dado que el codificador produce una diapositiva por turno, cada lámina funciona como un rollout corto e independientemente verificable.
En paralelo, los investigadores trabajan para cerrar la brecha en presentaciones cargadas de figuras mediante la extracción de gráficos desde documentos origen con herramientas como Docling para ubicarlos con el arnés. También exploran una vía ligera para adoptar plantillas propias sin reentrenar: reestilizar la salida a partir de uno o dos archivos .pptx existentes del usuario.
El desarrollo de Palette dejó cuatro principios de ingeniería aplicables a otros formatos estructurados verificables mediante código, como diagramas, gráficos o interfaces (UI layouts):
- Incluir el razonamiento en los datos: entrenar sobre por qué se elige una opción y por qué se descarta la alternativa enseña reglas generales mejor que mostrar solo el resultado final.
- Corregir los ejemplos antes de añadir reglas: los modelos teacher imitan las referencias incluidas en el prompt mucho más de lo que obedecen instrucciones textuales adicionales.
- Reparaciones seguras por defecto: conservar una reescritura solo cuando mejora de forma verificable permite ejecutar el arnés en todas las salidas sin riesgo de retroceso.
- Construir primero el verificador: disponer de un comprobador automático desde el inicio garantiza tanto la calidad de los datos sintéticos como la seguridad de las entregas finales.
Fuente: Palette: teaching a small model to build decks in your design language