Mistral Large 4 «Le Chonk» debuta en Hugging Face: MoE de 1 billón de parámetros y 1 millón de tokens de contexto
Mistral Large 4 «Le Chonk» debuta con 1 billón de parámetros, 49.000 millones activos, contexto de 1 millón de tokens y foco en código y ciberseguridad.
Mistral AI ha publicado Mistral Large 4 —conocido internamente como «Le Chonk» y abreviado ML4—, un modelo fundacional multimodal y multilingüe con arquitectura Mixture-of-Experts (MoE) que procesa texto e imágenes para generar respuestas textuales. Con aproximadamente 1 billón de parámetros totales, 49.000 millones de parámetros activos y una ventana de contexto (context window) de 1 millón de tokens, el lanzamiento destaca en ciberseguridad, agentes de programación y tareas multimodales, según detalla el blog técnico de Hugging Face.
Todos los checkpoints están reunidos en la colección oficial de Mistral Large 4 e incluyen dos variantes principales en pesos abiertos (open weights): el modelo en precisión FP8 (mistralai/Mistral-Large-4-1T-A52B) y la edición cuantizada en NVFP4 (mistralai/Mistral-Large-4-1T-A52B-NVFP4). A estas ediciones oficiales se suman cuantizaciones en formato GGUF preparadas por Unsloth y por el equipo de llama.cpp.
El modelo se distribuye bajo la licencia Mistral Ecosystem Open-Weight License, una variante derivada de MIT que establece limitaciones para servicios comerciales de modelo como servicio (model-as-a-service). Su ecosistema de despliegue incorpora compatibilidad desde el primer día en herramientas estándar de inferencia, ajuste fino y servidores empresariales.
Arquitectura híbrida: doble dispersión y codificador Pixtral
Mistral Large 4 combina un amplio conjunto de expertos con mecanismos de atención dispersa (sparse attention) y un codificador visual Pixtral. Este diseño aplica dos formas complementarias de dispersión: el modelo de lenguaje activa únicamente una fracción reducida de redes feed-forward por token, mientras un indexador selecciona qué posiciones previas del contexto reciben atención.
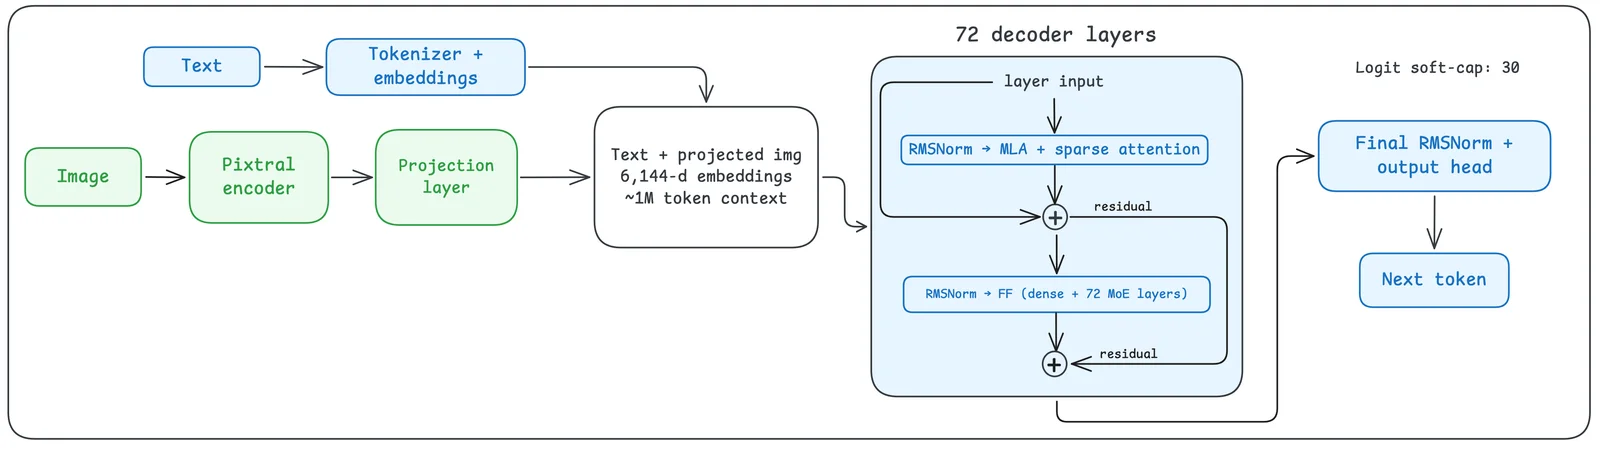
Vista general de la arquitectura del decodificador de texto de Mistral Large 4 (Hugging Face).
En el decodificador de texto, los bloques de atención combinan Multi-head Latent Attention (MLA) con un indexador DeepSeek Sparse Attention (DSA), una línea arquitectónica compartida con modelos recientes como GLM 5.3. Mientras MLA mantiene una representación comprimida del estado clave-valor (KV), el componente DSA filtra los candidatos más relevantes para cada consulta.
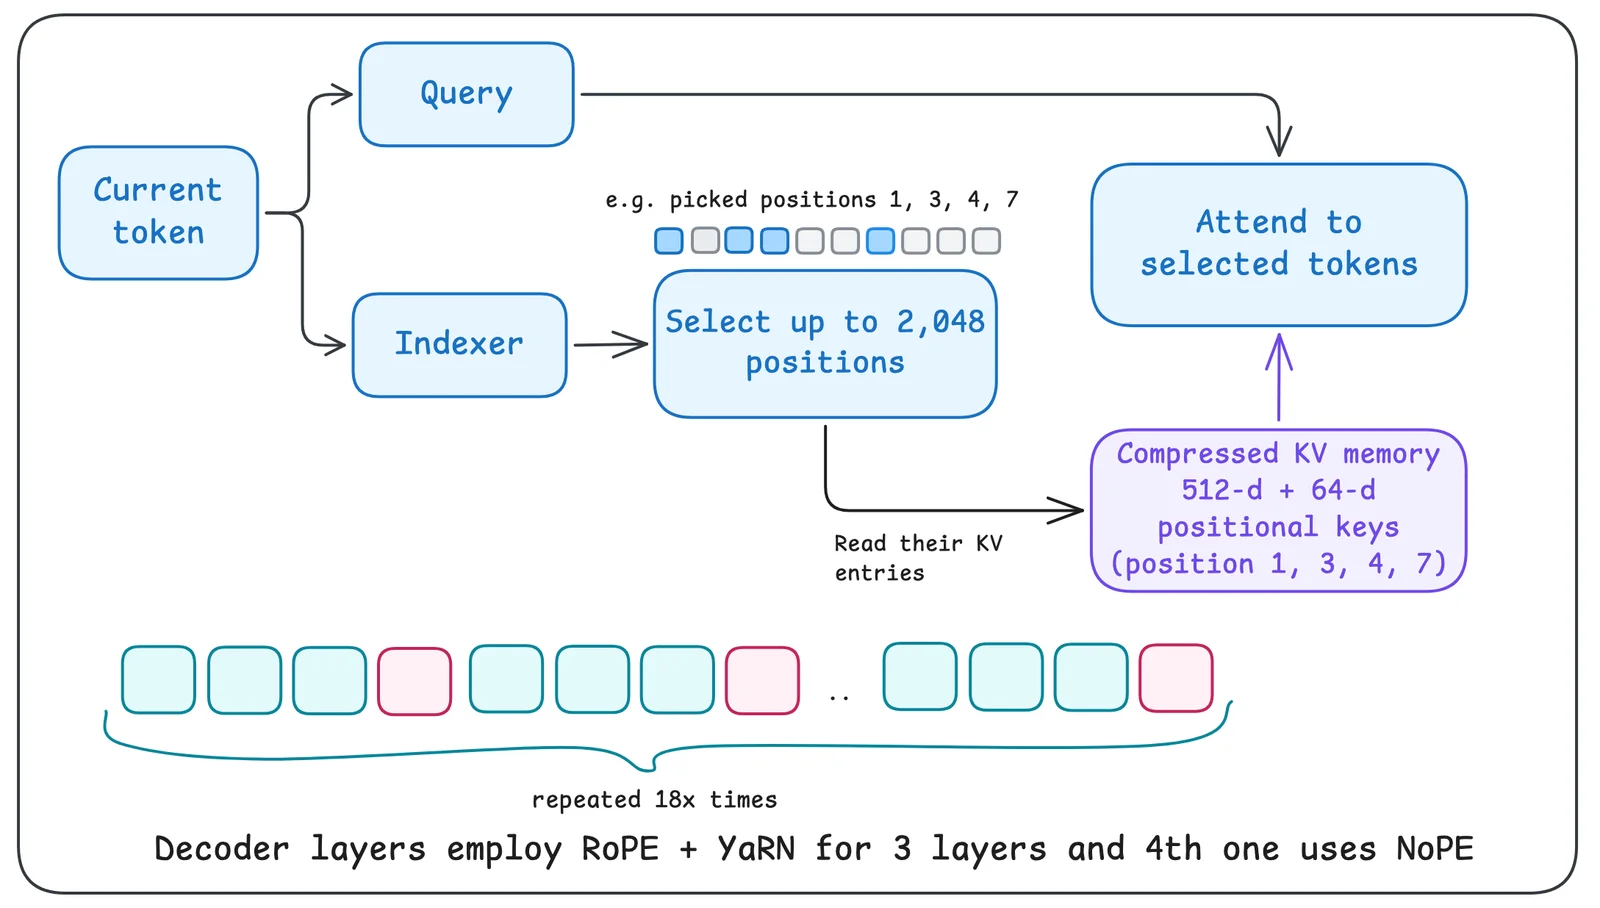
Bloques de atención con Multi-head Latent Attention (MLA), indexador DeepSeek Sparse Attention (DSA) y alternancia RoPE y NoPE en Mistral Large 4 (Hugging Face).
La codificación posicional sigue un patrón 3:1 de RoPE frente a NoPE, alternando tres capas con rotación posicional por cada cuarta capa sin codificación explícita, además de compartir estado KV entre capas. Para las capas RoPE, Mistral AI utiliza LeRope, una variante escalada mediante YaRN con un multiplicador aprendido por frecuencia.
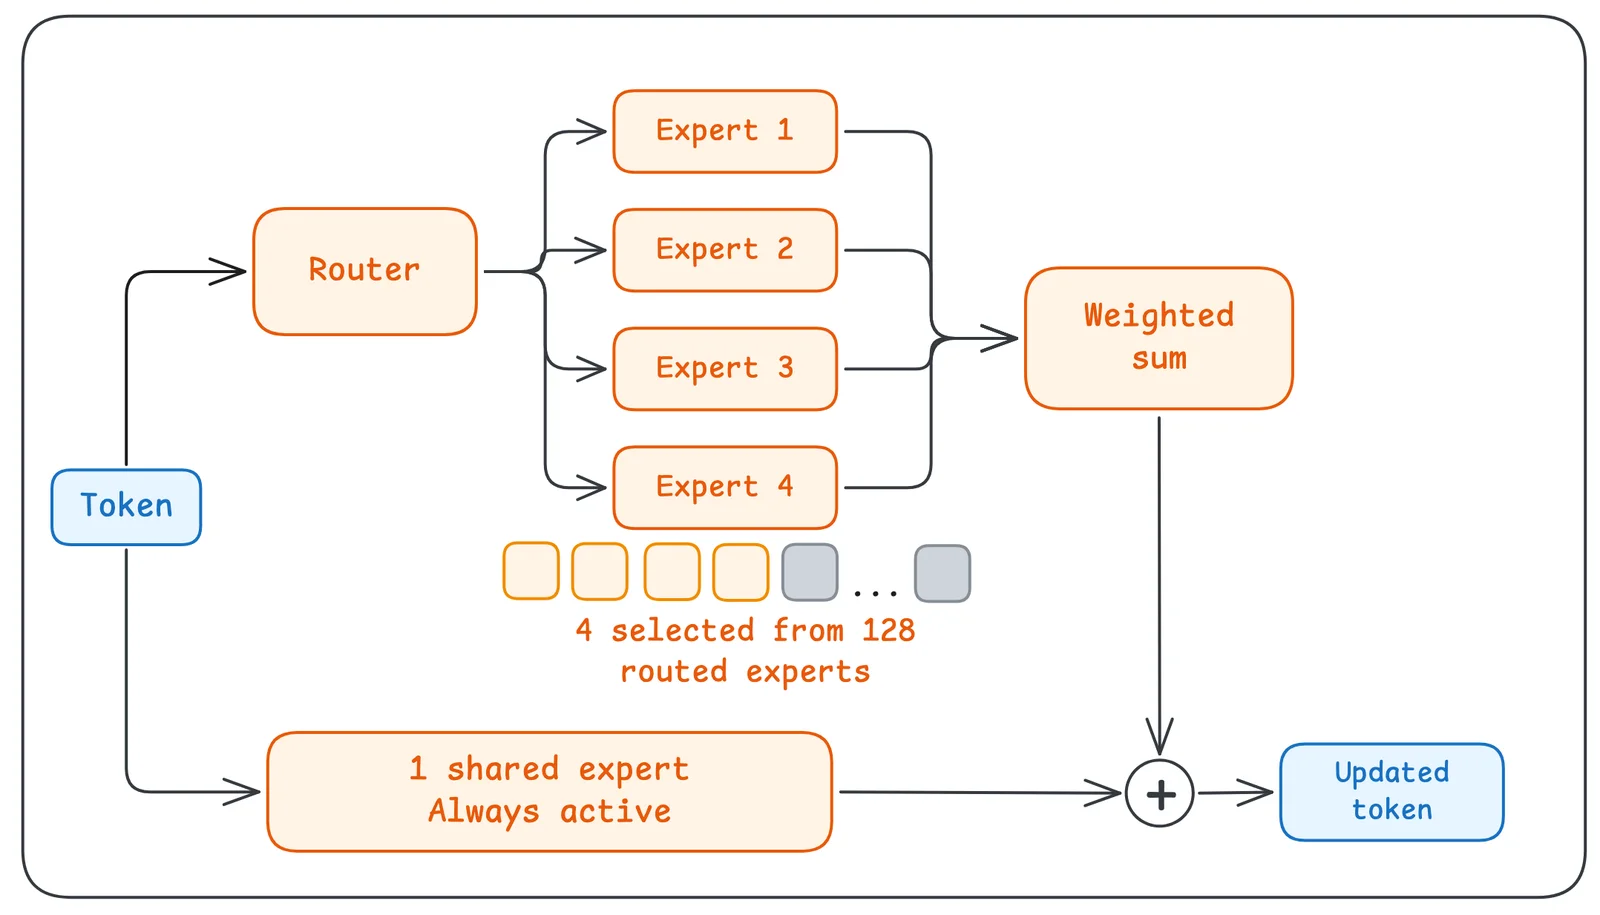
Enrutamiento Mixture-of-Experts mediante enrutador softmax y experto compartido en Mistral Large 4 (Hugging Face).
En la etapa feed-forward, únicamente la primera capa del decodificador emplea una red densa tradicional, mientras que el resto opera mediante bloques MoE gobernados por un enrutador softmax y un experto compartido permanente. Para procesar imágenes, el sistema integra un codificador Pixtral con proyector de fusión espacial (patch-merge projector).
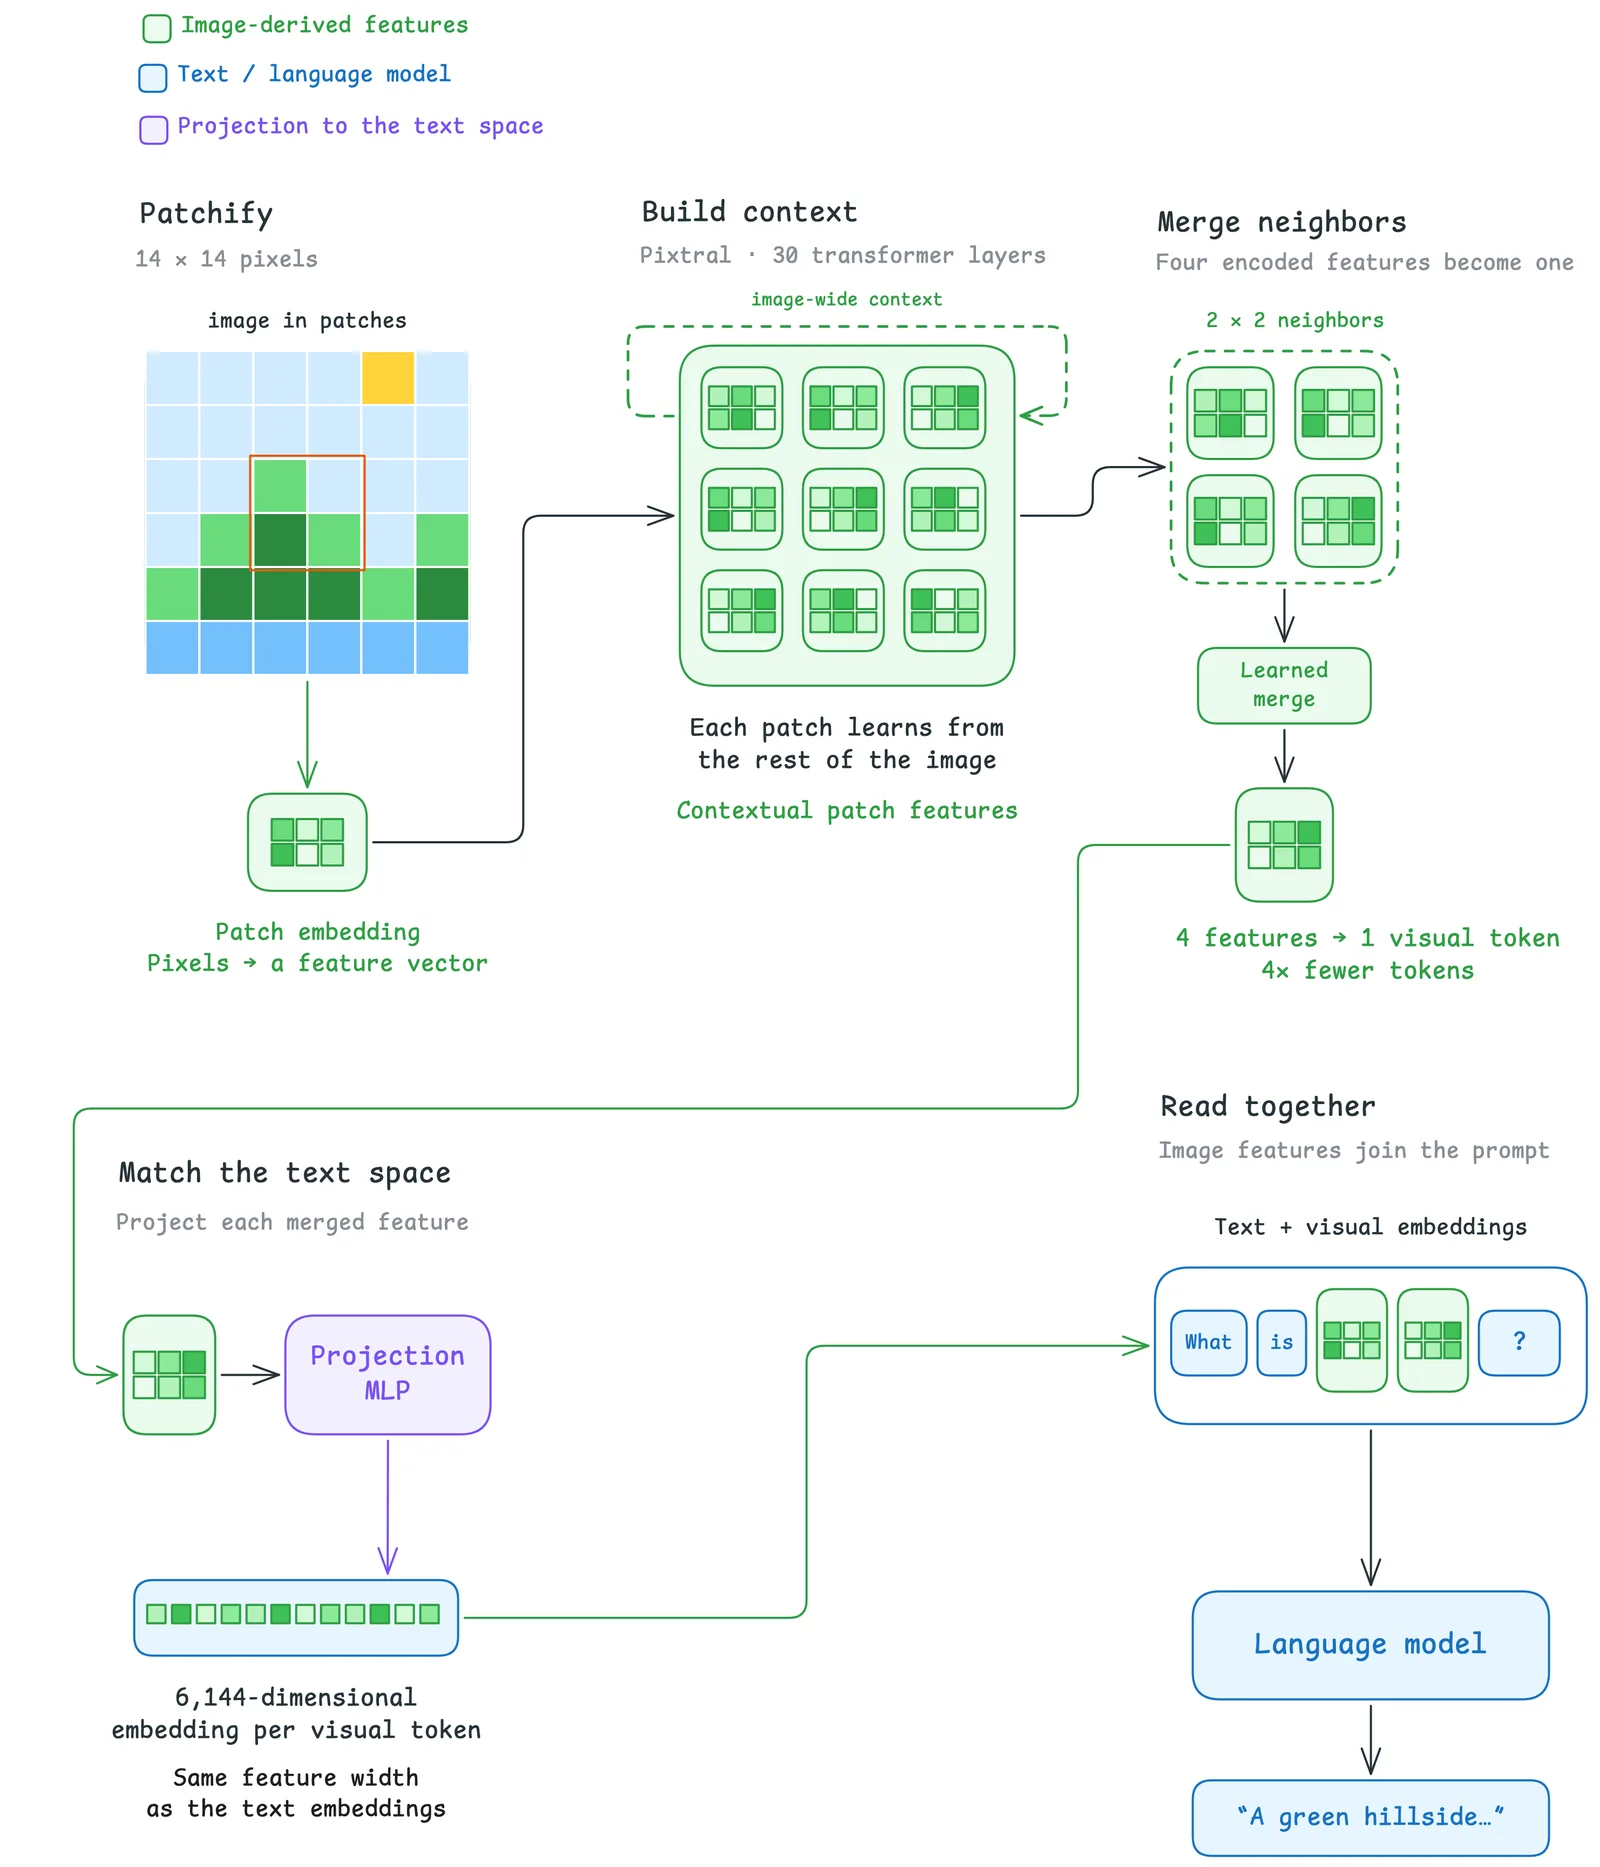
Canalización del codificador visual Pixtral de 1.600 millones de parámetros y su proyector de fusión espacial en Mistral Large 4 (Hugging Face).
La siguiente tabla resume las especificaciones estructurales de ambos módulos del modelo:
| Componente | Parámetros y escala | Capas y dimensión oculta | Configuración interna |
|---|---|---|---|
| Decodificador de texto | ~1 billón totales; 49.000 millones activos | 72 capas; dimensión oculta 6.144; 64 cabezas de atención | MLA con KV compartido entre capas + DSA (hasta 2.048 posiciones clave por consulta) |
| Codificación posicional | Ventana de 1 millón de tokens | Patrón 3:1 (RoPE / NoPE) por bloque | LeRope (YaRN con multiplicador aprendido por frecuencia) |
| Bloques MoE | 5 expertos activos por token | Capa 1 densa; 71 capas MoE | Enrutador softmax (4 seleccionados de 128) + 1 experto compartido fijo |
| Codificador visual Pixtral | 1.600 millones de parámetros | 30 capas; dimensión oculta 2.048; 16 cabezas | Parches de 14 × 14 con proyector patch-merge (fusión espacial de tamaño 2) |
Ciberseguridad defensiva, tasas de rechazo y agentes de código
Al 29 de octubre de 2026, Mistral Large 4 figuraba como el quinto mejor modelo de pesos abiertos en el índice Artificial Analysis Intelligence y entre los cinco primeros puestos globales en el Artificial Analysis Cyber Index. En agentes de programación, su resultado combinado en el Coding Agent Index superó a DeepSeek V4 Pro 0813 y Qwen3.8 Max, con desempeño sólido también en tareas empresariales de horizonte largo.
Mistral AI posiciona el modelo principalmente para seguridad defensiva, un terreno donde investigar vulnerabilidades y responder a incidentes suele asemejarse a un ataque en los datos de entrada. De acuerdo con la documentación publicada junto al lanzamiento —que incluye una entrevista en vídeo con Pierre Stock sobre estas capacidades—, varios modelos cerrados de frontera rozan el cero en pruebas de reproducción y parcheo porque sus filtros bloquean el intento, aunque corregir un fallo requiere reproducirlo antes.
En operaciones reales, depender de una API cerrada también conlleva el riesgo de perder acceso en medio de un incidente. Los pesos abiertos dejan la política de uso y el despliegue bajo control del equipo defensor sin eliminar las salvaguardas: en JailbreakBench, StrongREJECT y AgentHarm, ML4 mantuvo una tasa media de rechazo ante peticiones cibernéticas dañinas superior a la de cualquier otro modelo abierto comparable.
Más allá de los benchmarks estandarizados, las pruebas internas de Mistral AI reflejaron utilidad en análisis de malware, priorización de vulnerabilidades y redacción de reglas de detección sin entrenamiento explícito para esas funciones. Asimismo, la recompensa verificable de las tareas de reproducción y parcheo permite alimentar entornos de aprendizaje por refuerzo (RL) y ajustar modelos de seguridad más compactos sobre bases de código propias, registros de fallos (crash logs) y muestras reales.
| Categoría | Evaluación / Benchmark | Resultado de Mistral Large 4 | Alcance o referencia comparada |
|---|---|---|---|
| Agentes de código | DeepSWE v1.1 | 61,7 % | Resolución autónoma de ingeniería de software |
| Agentes de código | SWE-Atlas-QnA | 59,4 % | Comprensión y consultas sobre repositorios |
| Agentes de código | Terminal-Bench 4 | 28,3 % | Ejecución autónoma en terminal |
| Agentes de código | Coding Agent Index | 49,8 % | Por delante de DeepSeek V4 Pro 0813 y Qwen3.8 Max |
| Trabajo de conocimiento | AutomationBench | 59,9 % | Flujos de trabajo empresariales |
| Trabajo de conocimiento | AA-Briefcase | 1.393 Elo | Tareas profesionales de largo horizonte |
| Ciberseguridad | Artificial Analysis Cyber Index (parcheo) | 82 % (entre los 5 mejores globales) | Mayor puntuación del índice en reproducir y parchear fallos open source |
| Ciberseguridad | Cybench | 93 % | Resuelve el 93 % de 40 retos de competiciones de seguridad |
| Seguridad ante inyección | Lakera B3 | 93,3 % | Resistencia frente a ataques de prompt injection |
Inferencia desde el día cero, cuantizaciones locales y ajuste fino
El lanzamiento llega acompañado de soporte inmediato en transformers, vLLM, llama.cpp y la biblioteca TRL. En transformers, la interfaz expone AutoModelForMultimodalLM y AutoProcessor junto a DistributedConfig para paralelismo de tensor y expertos, además del parámetro reasoning_effort (low, medium o high por defecto), un modo de razonamiento que no puede desactivarse y conserva high si se solicita none.
Para inferencia acelerada, vLLM admite el checkpoint oficial NVFP4 sobre GPU NVIDIA Blackwell e incorpora el cabezal especulativo DSpark para reducir la latencia de generación. En paralelo, llama.cpp y Llama App habilitan una interfaz web local en el puerto 9931 y API multimodal con llamadas a herramientas mediante las cuantizaciones IQ2_XXS, Q2_K, Q4_K_M, NVFP4, Q8_0 y BF16 en los repositorios GGUF derivado de FP8 y GGUF derivado de NVFP4.
En hardware local, las cuantizaciones de 2 bits pueden ejecutarse en un único equipo Apple Silicon Ultra con 512 GB de memoria unificada, mientras que las precisiones superiores requieren inferencia distribuida o varias tarjetas NVIDIA o AMD. Para despliegues gestionados, Hugging Face Inference Endpoints ejecuta la variante FP8 sobre vLLM con decodificación especulativa DSpark, entregando el resultado en choices[0].message.content, el razonamiento en choices[0].message.reasoning y soporte para herramientas, salidas estructuradas, imágenes y streaming.
El ajuste fino (fine-tuning) cuenta con integración desde el primer día mediante SFTTrainer, AutoModelForImageTextToText y adaptadores LoRA con peft, combinando FSDP y paralelismo de expertos. El ejemplo oficial de TRL entrena razonamiento multilingüe con HuggingFaceH4/Multilingual-Thinking sobre nodos B300, mientras que Dell Enterprise Hub ofrece recetas mediante dell-ai para servidores Dell AI equipados con NVIDIA H200, B200, GB200 y GB300.
| Entorno / Plataforma | Variante y formato | Hardware de referencia | Métricas o configuración documentada |
|---|---|---|---|
llama.cpp | Q2_K | 1 × Apple M3 Ultra (512 GB RAM unificada) | Prefill de ~90 tok/s; generación de 15 tok/s |
llama.cpp | NVFP4 | 4 × NVIDIA RTX 6000 Pro | Contexto 32K; prefill 130–590 tok/s; generación ~10 tok/s |
llama.cpp | IQ2_XXS | 4 × NVIDIA RTX 6000 Pro | Contexto 800K; contexto corto: 500 tok/s (prefill) y 30 tok/s (gen.); contexto largo: 129 tok/s (prefill) y 3 tok/s (gen.) |
HF Inference Endpoints (vLLM + DSpark) | FP8 | 8 × NVIDIA H200 | Contexto 131K y hasta 16 peticiones simultáneas; petición única (1K): ~0,6 s TTFT, ~65 tok/s (hasta 120–138 tok/s con DSpark); 4 × 16K: 4.300 tok/s (prefill, 8–9 s TTFT); bajo carga (1.000 chats ShareGPT): ~480 tok/s totales |
vLLM (autoalojado) | NVFP4 + DSpark | 8 × NVIDIA Blackwell | Contexto 131.072 tokens (--tensor-parallel-size 8, --enable-expert-parallel) |
TRL (SFTTrainer + LoRA) | FP8 | 8 × NVIDIA B300 | Entrenamiento SFT distribuido (FSDP + paralelismo de expertos) |
Dell Enterprise Hub (dell-ai) | NVFP4 | 4 × NVIDIA B300 (xe9780-nvidia-b300) | Receta en Docker para servidores Dell AI (H200, B200, GB200, GB300) |
Fuente: Hugging Face